这一周 X 上关于 DeepSeek 的讨论,基本都绕着 DeepSeek-V4.1-Flash-1017(大家简称“1017”)转。OpenRouter 10 月 19–25 日的周榜上,它单周调用量 33.6 万亿 token,排第一(每经网报道)。OpenCode 的实时榜也有人截图,说它 24 小时跑了 8.5T token(@NFT_Chen)。
热度之外,中文圈问得最多的其实是两件事:
- 同一个 1017,接 Claude Code、DeepSeek Harness(DSH)还是别的 agent,哪个更划算?(@jackyang886 这条问的就是这个)
- 到底多少钱? 百度搜索框里“deepseek 1017 价格”“费用”“缓存命中”都排在联想词前面。
我九月写过 DeepSeek V4.1 Flash 接进 OMP 和 DSH,那时候用的还是上一版 V4.1 Flash。这篇换到 1017,只讲 Claude Code:怎么配、怎么算钱、哪几个设置会让账单翻倍。最后附一张几套 harness 跑 1017 的第三方对比表。
先说结论:
- 模型名就是
deepseek-flash,现在背后就是 1017。API 调用方式和价格都没变。 - Claude Code 一定要把几个模型变量都设上。 只改
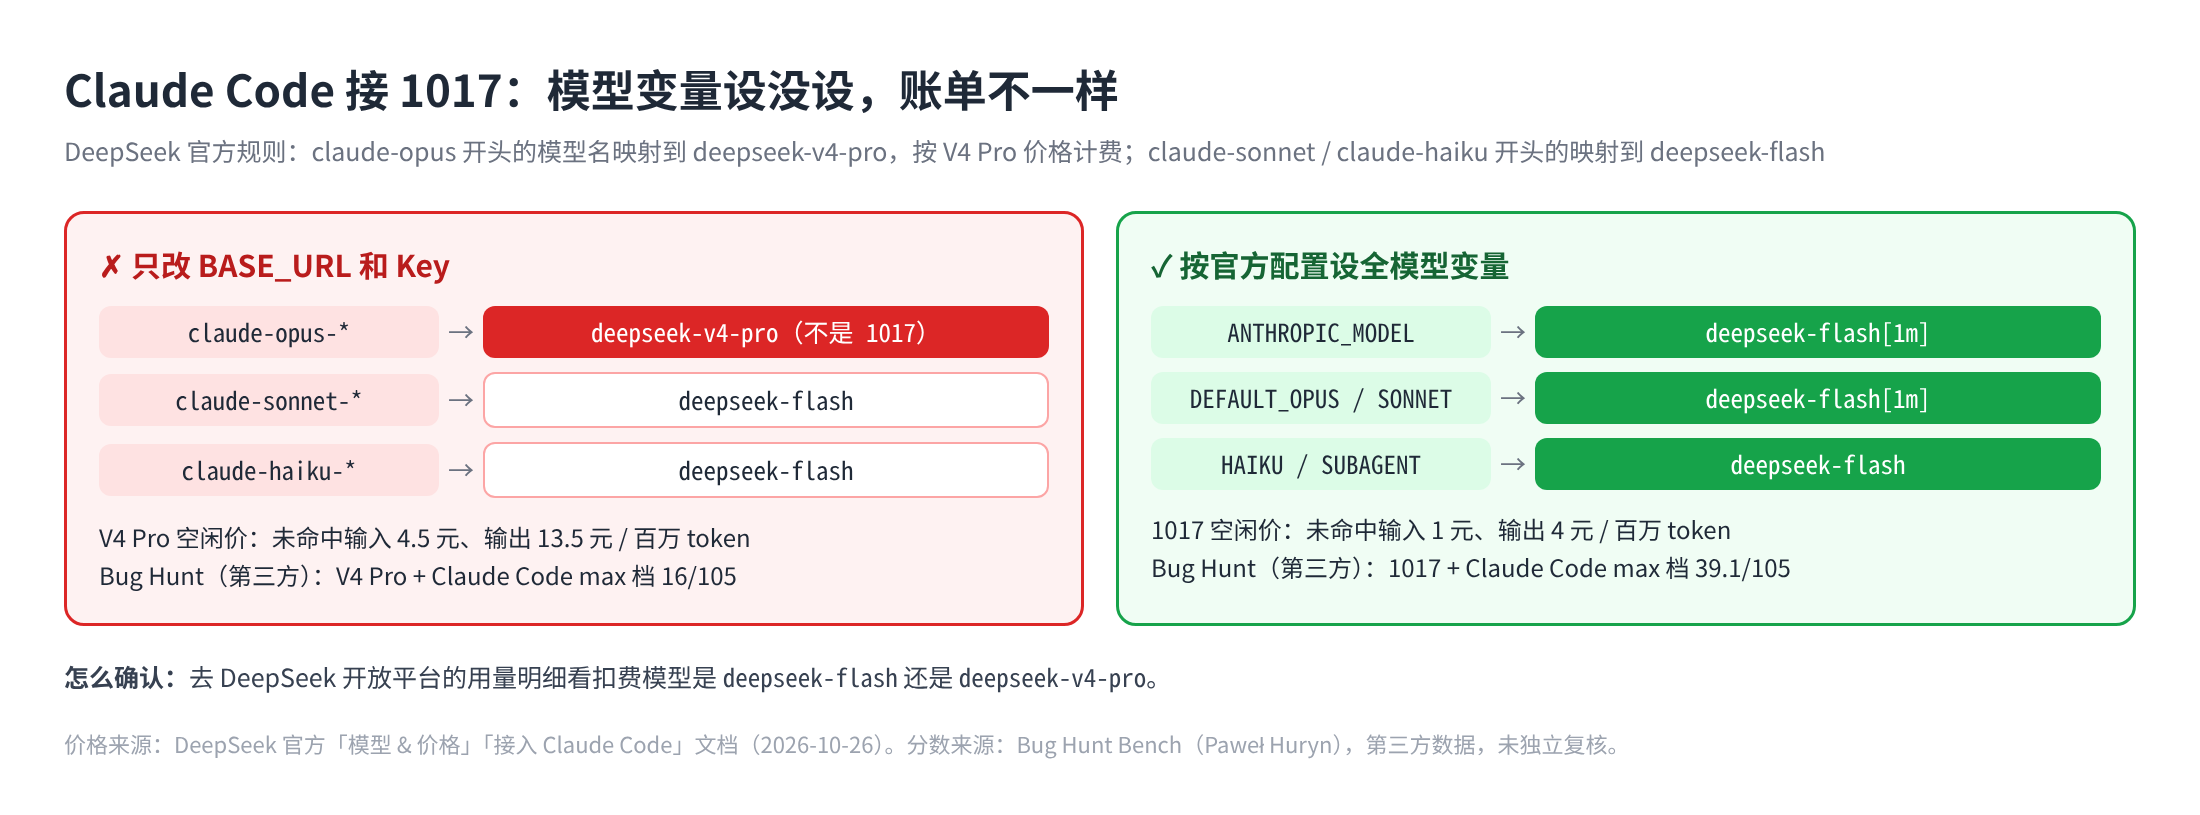
BASE_URL和 Key 的话,claude-opus-*会被映射到 V4 Pro,按 Pro 的价格算。 - 省钱主要靠两样:缓存命中和错峰。 缓存命中的输入价只有未命中的 1/50,空闲时段又比高峰便宜一半。
- 北京时间 11 月 1 日 00:00 起,Claude Code 里的联网搜索开始按次收费,Search 和 Fetch 都是 5 元 / 千次。
- 选哪个 harness:在第三方的 Bug Hunt 测试里,DSH 分数最高但最贵;Pi 分数接近、账单不到 DSH 的一半;Claude Code 比 DSH 低 3.6 分,账单比 DSH 便宜约 45%。
说明:本文所有价格和配置都对照 2026 年 10 月 26 日的 DeepSeek 官方文档。所有分数和成本都是第三方公开数据,我没有独立复核。价格可能会调,以官方页面为准。
一、1017 是什么:一句话版本
- 名字:
DeepSeek-V4.1-Flash-1017,10 月 17 日发布,是 V4.1 Flash 的小版本更新。官网、App 和 API 已经同步切换(官方更新日志)。 - 开源了吗:开了。权重在 Hugging Face,MIT 协议。
- 上下文:1M,最大输出 384K(模型与价格)。
- 官方分数(对比上一版 V4.1 Flash):Terminal-Bench 4.0 从 31.2 到 42.3,DeepSWE v1.1 从 74.2 到 77.0。注意 Terminal-Bench 4.0 是用 Claude Code 框架测的,DeepSWE 用的是 Mini-SWE-V2 框架。
- 官方说的变化:任务耗时更短、输出更短、成本更低,并且专门针对 DSH、腾讯 CodeBuddy、WorkBuddy 做过优化。DSH 要升到 0.2.1-rc.1 及以上。
最后一点值得留意:官方点名优化的是自家 DSH,而官方的 Terminal-Bench 分数又是在 Claude Code 里跑的。 所以“哪个 harness 更好”这个问题,官方其实没给答案,后面第五节看第三方数据。
二、Claude Code 接入 1017:官方配置
1. 安装 Claude Code
已经装好的话跳过这一步。官方文档要求 Node.js 18+,Windows 还需要装 Git for Windows:
npm install -g @anthropic-ai/claude-code
claude --version
2. 设置环境变量(macOS / Linux)
API Key 在 DeepSeek 开放平台 创建。下面这段跟官方「接入 Claude Code」页一字不差:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<你的 DeepSeek API Key>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
export CLAUDE_CODE_EFFORT_LEVEL=max
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
然后进项目目录直接跑:
cd /path/to/my-project
claude
Windows PowerShell 的写法是把每行换成 $env:变量名="值",官方页上有完整版本。
每一行的作用:
| 变量 | 作用 |
|---|---|
ANTHROPIC_BASE_URL |
指向 DeepSeek 的 Anthropic 兼容接口 |
ANTHROPIC_MODEL 和三个 DEFAULT_*_MODEL |
让 Claude Code 里的 Opus、Sonnet、Haiku 三档全部走 deepseek-flash。[1m] 告诉 Claude Code 使用 1M 上下文 |
CLAUDE_CODE_SUBAGENT_MODEL |
子 agent 也用 Flash |
CLAUDE_CODE_EFFORT_LEVEL=max |
思考强度开到最高,下面第五节会讲它对分数和成本的影响 |
CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432 |
上下文涨到约 768K token 时自动压缩,不会等到撑满 1M |
不想每次开终端都 export,可以把同样这些键值写进 ~/.claude/settings.json 的 "env" 字段。DeepSeek 官方的 awesome-deepseek-agent 推荐的就是这种写法,CLI 和 VS Code 插件都会读这个文件。注意那份示例里的模型名还是旧的 deepseek-v4-pro / deepseek-v4-flash,换成 deepseek-flash。
3. 先用 curl 确认 Key 和模型可用
进 Claude Code 之前,可以先用官方示例确认 Key 能用:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-flash",
        "messages": [{"role": "user", "content": "Hello!"}],
        "thinking": {"type": "enabled"},
        "reasoning_effort": "high",
        "stream": false
      }'
返回里的 usage 有两个字段:prompt_cache_hit_tokens 和 prompt_cache_miss_tokens。第四节算钱时就看它们。
三、最容易踩的坑:claude-opus 会被映射到 V4 Pro
官方文档原话:
claude-opus 开头的模型,会映射到
deepseek-v4-pro;claude-haiku、claude-sonnet 开头的模型,会映射到deepseek-flash。claude-opus 映射到的deepseek-v4-pro按 V4 Pro 价格计费。
也就是说,假如你只改了 ANTHROPIC_BASE_URL 和 Key,没设上面那几个模型变量,Claude Code 发出去的又是 Opus 系列的模型名,那么你实际用的是 V4 Pro,不是 1017,价格也贵好几倍:
| 每百万 token(人民币) | deepseek-flash(1017) |
deepseek-v4-pro |
|---|---|---|
| 输入,缓存命中(空闲 / 高峰) | 0.02 / 0.04 元 | 0.15 / 0.30 元 |
| 输入,缓存未命中(空闲 / 高峰) | 1 / 2 元 | 4.5 / 9 元 |
| 输出(空闲 / 高峰) | 4 / 8 元 | 13.5 / 27 元 |
而且按 Bug Hunt 的数据,V4 Pro 在 Claude Code 里的分数(max 档 16/105)远低于 1017(39.1/105),等于多花钱换来更差的结果。判断方法很简单:去开放平台的用量明细看,扣费模型是 deepseek-flash 还是 deepseek-v4-pro。
四、1017 到底多少钱:4 个省钱设置
价格表(官方,人民币)
| 项目 | 空闲时段 | 高峰时段 |
|---|---|---|
| 输入(缓存命中) | 0.02 元 / 百万 token | 0.04 元 / 百万 token |
| 输入(缓存未命中) | 1 元 / 百万 token | 2 元 / 百万 token |
| 输出 | 4 元 / 百万 token | 8 元 / 百万 token |
| Search API | 5 元 / 千次成功请求 | 同左 |
| Fetch API | 5 元 / 千次成功请求 | 同左 |
高峰时段:北京时间周一到周五(不含法定节假日)的 9:00–12:00 和 14:00–18:00。其余时间都算空闲,包括周末和法定节假日全天。美元价格是空闲 $0.15 / $0.60,高峰翻倍(见英文定价页)。
设置 1:让缓存多命中
DeepSeek 的硬盘缓存默认开启,按前缀匹配:后一次请求的开头必须完整覆盖前一次已经落盘的前缀单元,才算命中(上下文硬盘缓存)。coding agent 每一轮都会重发系统提示、工具定义和之前的对话,天然适合吃缓存。下面几种操作会让缓存失效:
- 会话中途改系统提示、换 MCP 工具列表或改
CLAUDE.md,前缀变了,之后的请求就从头算; - 频繁
/clear,或者在多个会话之间来回切换; - 缓存是“尽力而为”,几小时到几天后会被清掉,隔天再接着同一个会话不一定还能命中。
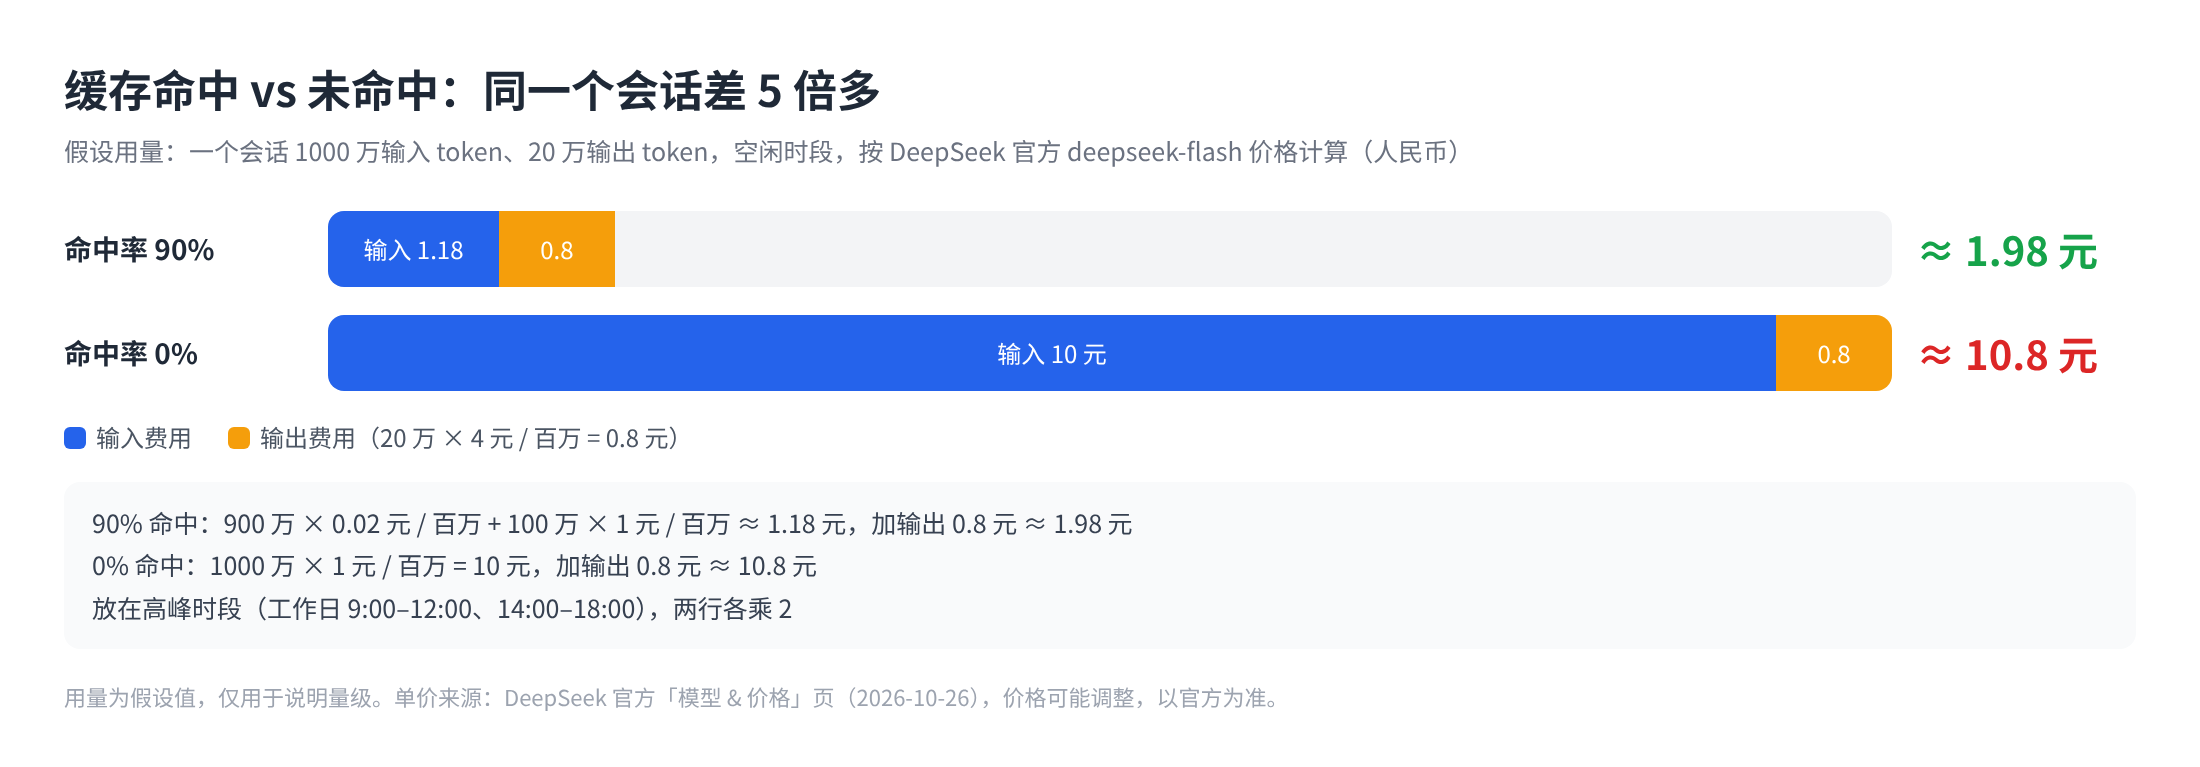
用一组假设的用量算一下差距:一个会话总共 1000 万输入 token、20 万输出 token,空闲时段。
| 缓存命中率 | 输入费用 | 输出费用 | 合计 |
|---|---|---|---|
| 90% | 900 万 × 0.02 + 100 万 × 1 ≈ 1.18 元 | 0.8 元 | 约 1.98 元 |
| 0% | 1000 万 × 1 = 10 元 | 0.8 元 | 约 10.8 元 |
同样的活,缓存命中与否能差 5 倍多。如果放在高峰时段,两行再各乘 2。
设置 2:错峰跑批量任务
空闲价是高峰的一半。批量修 bug、跑测试、扫仓库这类不急的活,放到工作日晚上或周末跑。
设置 3:思考强度按任务选
DeepSeek 实际只有 low / high / max 三档。Claude Code 传过去的其他档位会被映射:medium 和 xhigh 按 high 算,ultra 按 max 算(思考模式)。Bug Hunt 里 1017 + Claude Code 三档的数据是:
| 档位 | 修复数 / 105 | 单轮账单 |
|---|---|---|
| max | 39.1 | $1.01 |
| high | 36.4 | $0.82 |
| low | 34.4 | $0.71 |
max 比 low 多修 4.7 个 bug,账单多 42%。官方的建议是:简单任务用 low,日常 agent 任务用 high,复杂任务用 max。
设置 4:11 月 1 日之后留意联网搜索
DeepSeek 原生支持 Claude Code 的 Web Search:模型判断需要搜索时,会通过 DeepSeek 的 Search API 去搜。这部分目前不收费,从北京时间 2026 年 11 月 1 日 00:00 起按次计费(Search、Fetch 各 5 元 / 千次)。另外,搜索结果还要再交给模型总结,这一步的 token 也算钱。
一次 0.005 元看着不多,但一个爱查资料的 agent 一天能搜几百次。@ak12kpoot 按每天搜 300 次、抓 300 页算过,一个月大约 90 元,够买 9000 万空闲时段的未命中输入 token。所以 11 月以后,记得在 Claude Code 的权限里把 WebSearch / WebFetch 改成 ask,具体写法见 Claude Code 权限配置指南。
顺带一提:Qoder 官方宣布 1017 在 Qoder 里 0 credits 用到 11 月 1 日 00:00(UTC+8)(@qoder_ai_ide)。这周有不急的批量任务,可以趁免费期跑掉。
五、同一个 1017,换个 harness 差多少
这几天 X 上讨论最多的就是这张表。数据来自 Paweł Huryn 的 Bug Hunt Bench:在两个真实代码库里埋了 105 个 bug,让 agent 一轮内找出来并修好,按隐藏答案盲评。1017 的每一格都跑了 5–7 次取平均,成本是 DeepSeek API 的实际账单。
| Harness(1017,max 档) | 修复数 / 105 | 单轮账单 | 耗时 |
|---|---|---|---|
| DeepSeek Harness | 42.7 | $1.84 | 62 分钟 |
| Pi | 42.2 | $0.83 | 54 分钟 |
| Claude Code | 39.1 | $1.01 | 58 分钟 |
| OpenCode | 37.6 | $0.96 | 56 分钟 |
| 参照:Opus 5.5 + Claude Code | 41.7 | $58.53 | 67 分钟 |
| 参照:上一版 V4.1 Flash + Claude Code | 21.7 | $0.78 | 56 分钟 |
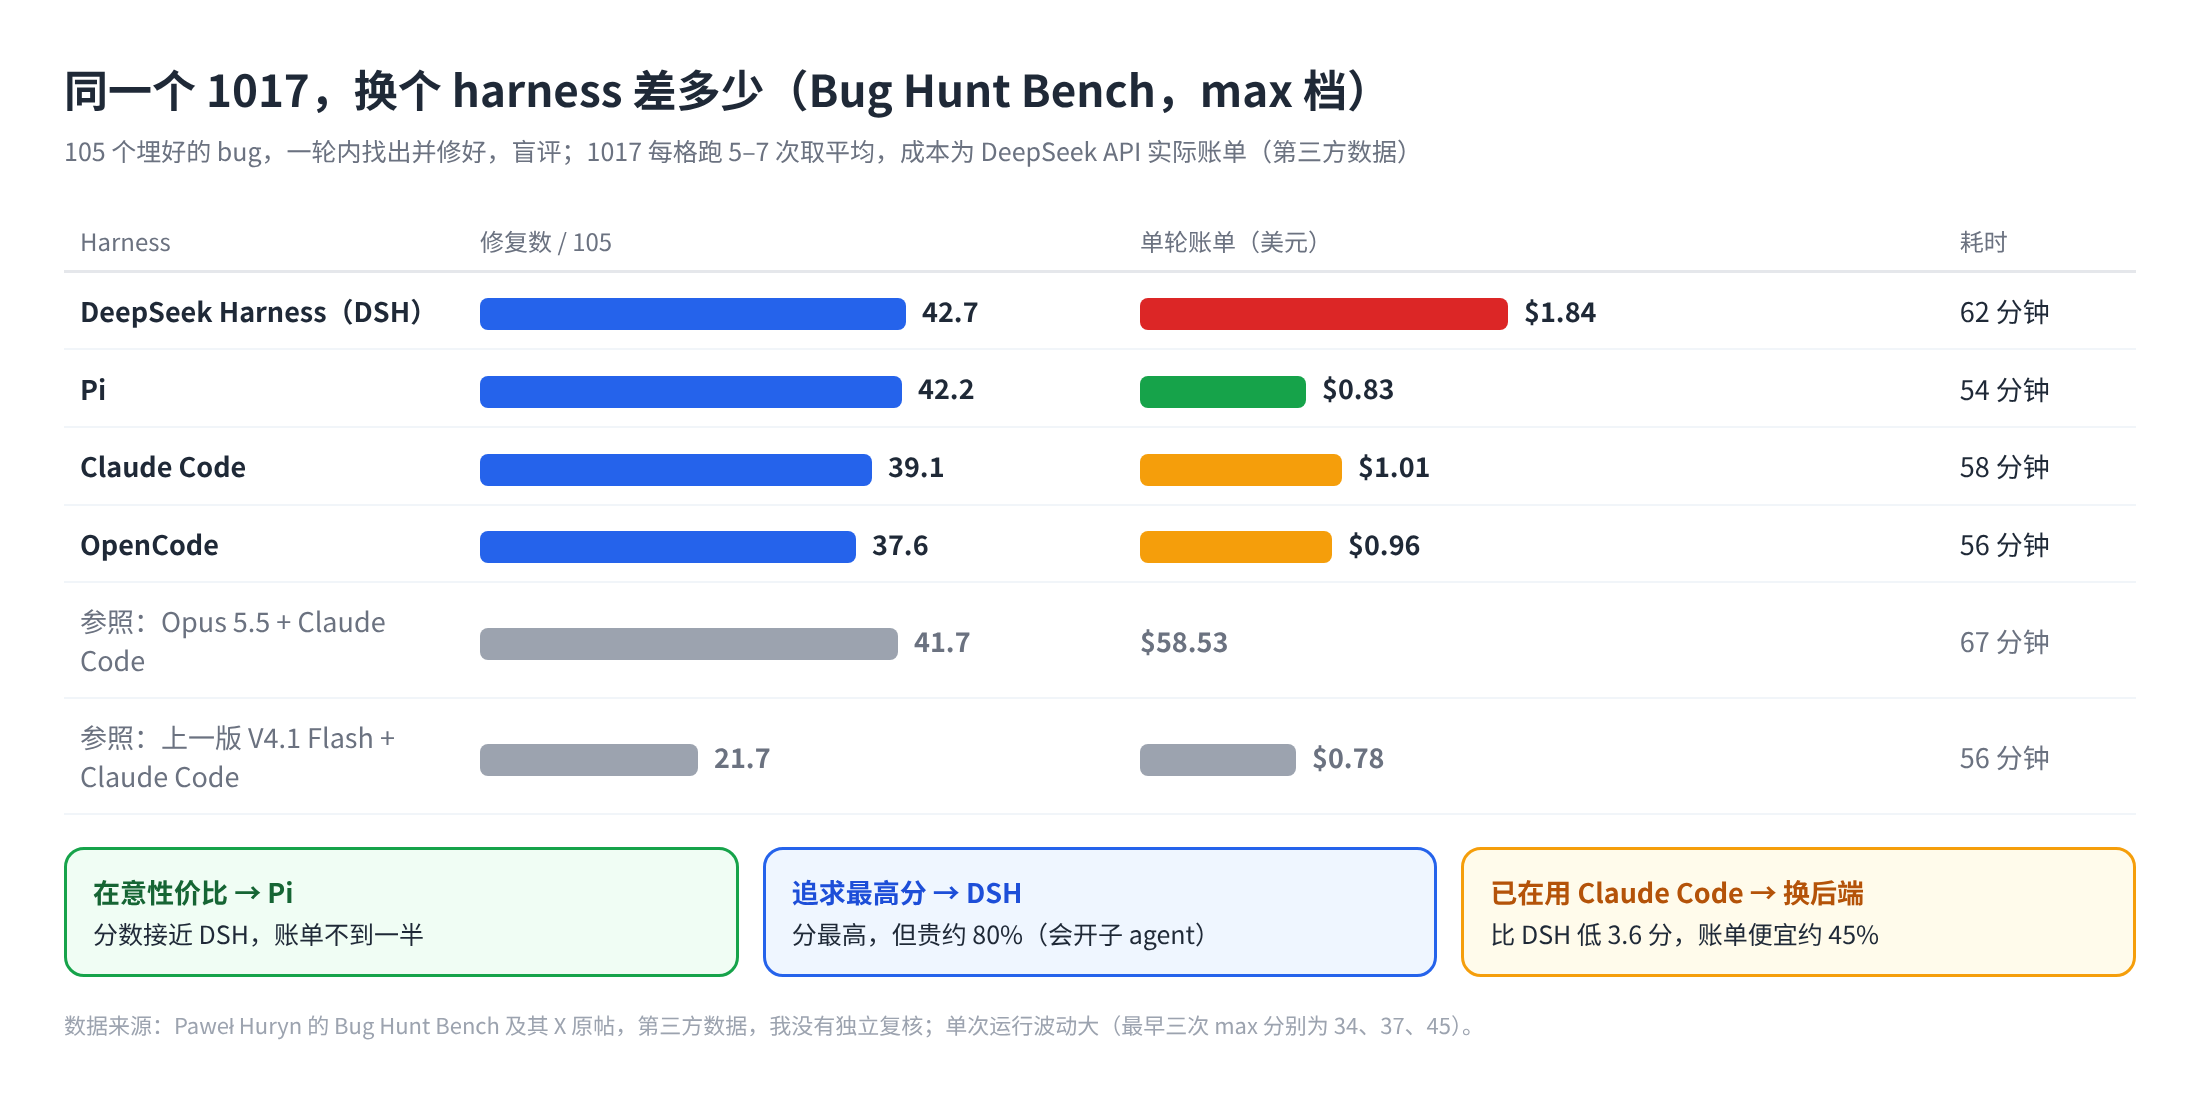
数据来自 Bug Hunt Bench 作者公开结果,我没有独立复核。
几点读法:
- DSH 分高,但贵了 80% 左右。 作者的解释是 DSH 会开子 agent,输出 token 也更多(原帖)。
- Pi 在这个测试里性价比最高:分数和 DSH 差不多,账单不到一半(@nextaurame 的总结)。
- Claude Code 比 DSH 低 3.6 分,但账单便宜约 45%。 如果你本来就天天用 Claude Code,换个后端就能用上,这是迁移成本最低的一条路。
- 1017 比上一版提升很大:同样是 Claude Code + max 档,从 21.7 到 39.1。
- 单次运行波动很大。 作者最早三次 max 跑出来分别是 34、37、45(原帖)。别拿自己跑一两次的结果下结论。
还有另外两组数据可以对照着看:
- 有人用 1017 在 Terminal-Bench 2.0 上对比了三套 harness,每套跑 20 个任务、各两轮。成功率 Claude Code 75%、Hermes 75%、DSH 70%,统计上没有显著差异。但 Claude Code 的输入 token 比 DSH 少约 40%(2321 万 vs 3868 万),平均工具交互 18 轮 vs 29 轮(转述自 @jamesgao_ai,原始来源未标明,仅供参考)。
- Artificial Analysis 10 月 23 日发布的 Coding Agent Index v2.0 里,Codex + DeepSeek V4.1 Flash 是 47.3 分、每题 $0.39;Claude Code + Opus 5.5 是 61.7 分、每题 $11.42(AA 对比页)。这份榜单里没有 Claude Code + DeepSeek 的组合。
最后提醒一句:不同 harness 的分数只能在同一个测试里比。同样是 1017 的 Terminal-Bench 4.0,DeepSeek 官方在 Claude Code 里测出 42.3,Vals AI 用只有 bash 的 mini-swe-agent 测出 31.82(@sonic_saurav),差了 10 分。
六、不用 Claude Code 的话:Codex 和 DSH 怎么接
Codex:DeepSeek 提供了一键脚本。运行前确认 ~/.codex 已经存在,也就是 Codex 至少启动过一次。脚本会先备份原来的配置,菜单第 1 项切到 deepseek-flash,第 9 项恢复原配置(接入 Codex):
bash <(curl -fsSL https://cdn.deepseek.com/api-docs/codex-deepseek-setup.sh)注意:Codex 内置的联网搜索只支持 deepseek-v4-pro,用 deepseek-flash 时脚本默认把它关掉(web_search = "disabled")。
DSH:启动方式和我九月那篇一样,在 Settings → Models 里填 deepseek-flash。官方建议升级到 0.2.1-rc.1 及以上:
npx @deepseek-ai/dsh web七、常见问题
1017 的模型名是什么? 直连 DeepSeek API 用 deepseek-flash。旧名 deepseek-v4-flash 还能调用,但实际也是 1017 在服务,按 Flash 价计费。第三方平台的模型 ID 各不相同,以平台文档为准。
1017 和之前的 V4.1 Flash 价格一样吗? 一样。官方更新日志写的是“API 调用方式与价格保持不变”。
1017 能本地部署吗? 权重是开源的,但模型很大:Hugging Face 统计的参数总量约 7632 亿。没有大内存的机器,就别考虑本地了。普通开发机直接用 API 最省事,Mac 能跑多大的模型可以看 Mac 本地推理选购指南。
为什么 1017 有时候思考特别久? Claude Code 按官方配置会开 max 档。日常小改动可以降到 high 或 low,见第四节的设置 3。
最后的判断
如果你已经在用 Claude Code,1017 是现在最便宜的“换个后端”方案:设好环境变量、确认扣费模型是 deepseek-flash、尽量别打断缓存、11 月前把联网搜索改成需要确认,这几件事做到,账单基本就可控了。
如果你更在意每一块钱能修几个 bug,第三方数据指向 Pi。如果你追求最高分、不介意多花一些,就用 DSH。不管选哪个,都按我在九月那篇里说的做:拿自己的 10 到 20 个真实任务,对比一次完成率和账单,而不是只看榜单。
一句话:1017 接 Claude Code,关键是模型变量设全,再把缓存和错峰用好。
参考资料
- DeepSeek API 更新日志(2026-10-17:DeepSeek-V4.1-Flash-1017 更新、开放搜索 API)
- DeepSeek API 模型 & 价格
- DeepSeek API:接入 Claude Code
- DeepSeek API:接入 Codex
- DeepSeek API:上下文硬盘缓存
- DeepSeek API:思考模式
- deepseek-ai/DeepSeek-V4.1-Flash-1017 · Hugging Face
- phuryn/bug-hunt-bench · GitHub
- Artificial Analysis:Claude Code vs Codex
- 每经网:DeepSeek 一款大模型单周调用量登顶全球第一
- X 讨论:@PawelHuryn、@jamesgao_ai、@ak12kpoot、@qoder_ai_ide、@nextaurame、@sonic_saurav
- 站内:DeepSeek V4.1 Flash 接进 OMP 和 DSH、Claude Code 权限配置指南、Mac 本地推理选购指南
Comments