最近本地模型圈同时刷到三个名字:Recursive Flint、Strata、千问 3.8。搜索时很容易把它们当成三个并列的「模型」——其实不是。
- Flint 是 Recursive 发布的 coding 专用 MoE 模型(官方代号约 40B-A2.5B)。
- Strata 是开源本地 运行时 / App,主模型跑的是千问开源权重。
- 千问 3.8 要拆开说:开源权重叫 Qwen3.8-Flash-Next;云端托管版叫 Qwen3.8-Flash(基于前者,并带更多生产特性)。我在 Mac 本地推理选购指南 里还写过 dense 的 Qwen3.8-27B,那是另一条线,本文不混进主表。
这篇只回答一个问题:本地或半本地跑 coding agent,这三者怎么选、怎么上手。 规格数字都对过官方文档;速度凡不是我自己测过的,一律标来源,第三方数字我未独立复核。
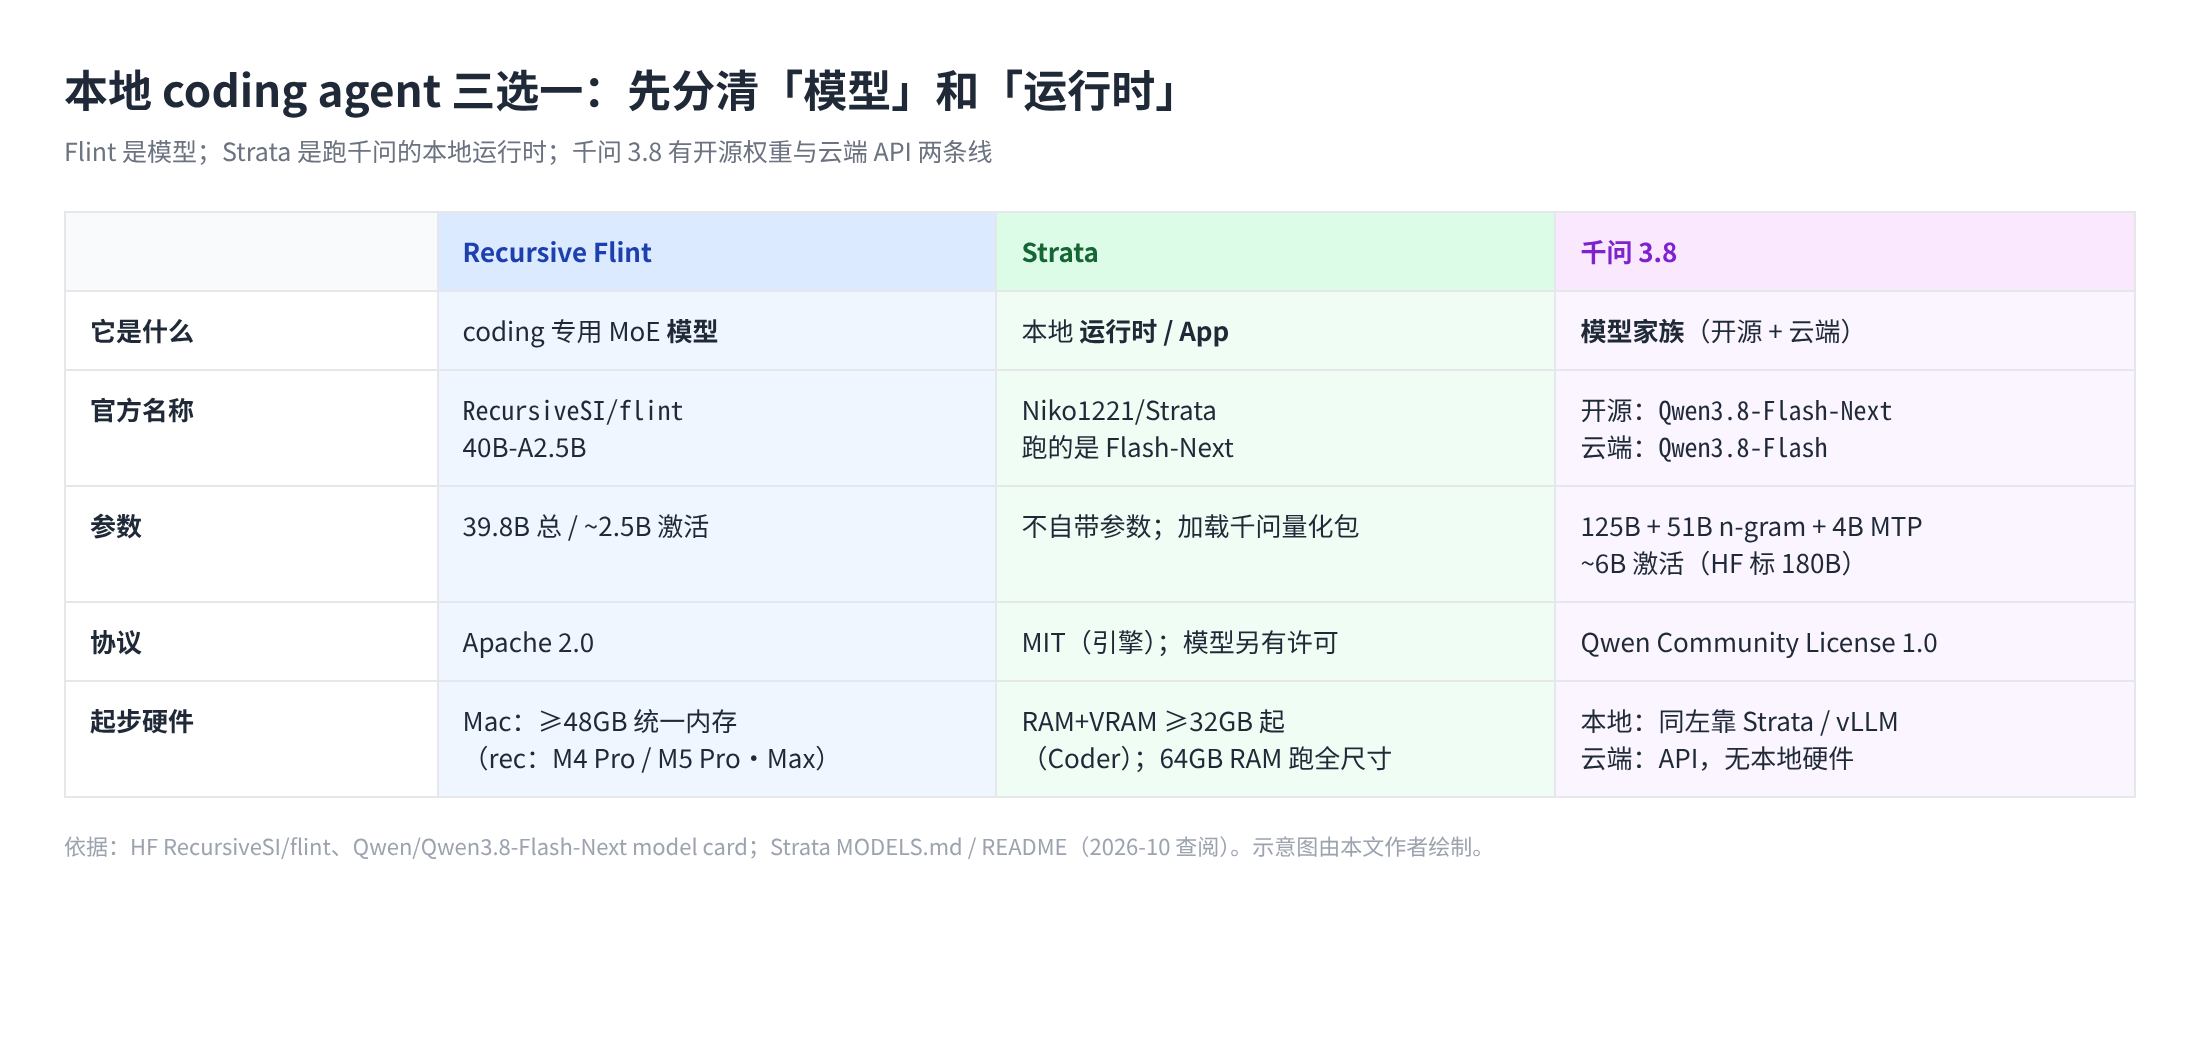
一、对照表:参数、协议、硬件
| Flint | Strata | 千问 3.8 | |
|---|---|---|---|
| 本质 | coding MoE 模型 | 本地 引擎 + UI + API | 模型家族 |
| 官方标识 | RecursiveSI/flint,40B-A2.5B |
Niko1221/Strata | 开源:Qwen/Qwen3.8-Flash-Next;云端:qwen3.8-flash |
| 总参数 / 激活 | 39.8B / 约 2.5B | 不自带;加载千问量化包 | 125B + 51B n-gram embedding + 4B MTP;约 6B 激活(HF 标 Model size 180B) |
| 上下文 | 文档配置 262,144;博客称最长可到 512k,建议日常 ≤256k | 随量化与内存,常见 128k–262k | Qwen3.8-Flash-Next:原生 262,144,可扩展到 1M;Qwen3.8-Flash:公开页写 Context 1M |
| 模态 | 文本 | 引擎可开图片(默认开) | Qwen3.8-Flash-Next / Qwen3.8-Flash:图文视频 → 文本 |
| 协议 | Apache 2.0 | 引擎 MIT;权重走千问许可 | Qwen Community License 1.0(商业 MaaS / AI Work Assistant 有额外条件) |
| 起步硬件 | Mac:≥48GB 统一内存;官方 rec 写明 M4 Pro / M5 Pro / M5 Max |
RAM+VRAM ≥32GB 可起 Coder;64GB RAM 可跑全尺寸 IQ3_S | 本地:同左,靠 Strata / vLLM / SGLang;云端:无本地大内存 |
| 适合什么 | 离线 Mac coding agent | 消费级独显机跑大 MoE | 要能力上限(本地权重或 API) |
Flint 官方评测(model card;Recursive 自测标 †):Terminal-Bench 2.1 54.9%,SWE-bench Pro v2 89.7%,SWE-bench Verified 74.2%。Qwen3.8-Flash-Next 的 model card 也有一套 agent / coding 表,评测 harness 与设置不同,分数不能直接横比。
二、速度数字:看来源,别横比
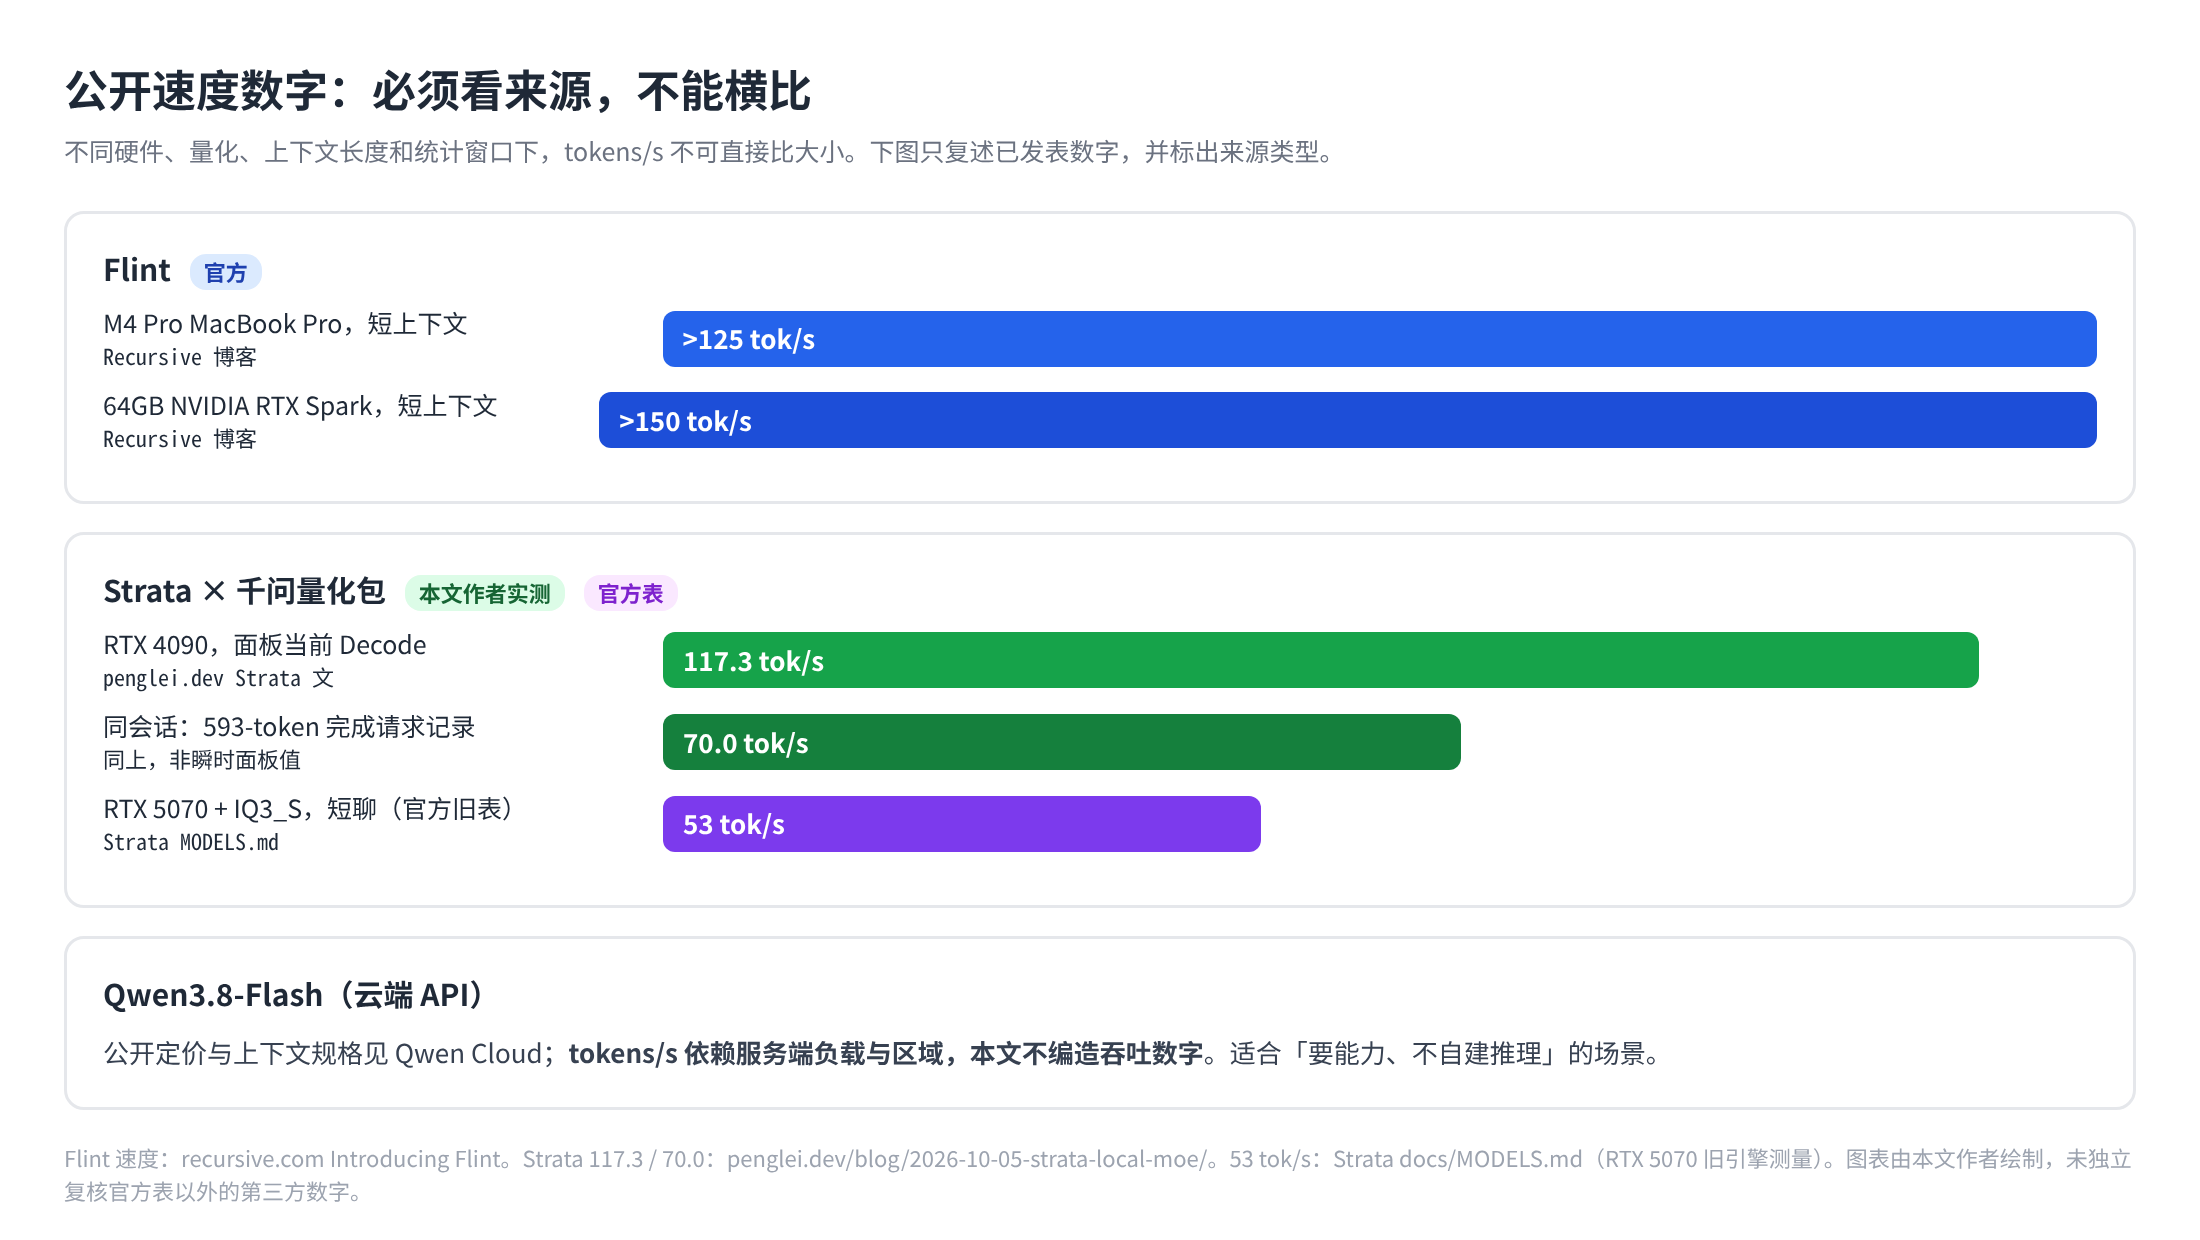
| 数字 | 条件(据原文) | 来源 |
|---|---|---|
| >125 tok/s | M4 Pro MacBook Pro,短上下文 | Recursive Introducing Flint(官方;我未复核) |
| >150 tok/s | 64GB NVIDIA RTX Spark,短上下文 | 同上(官方;我未复核) |
| 117.3 tok/s | RTX 4090,监控面板「当前 Decode」 | 我写的 Strata 实测 |
| 70.0 tok/s | 同会话一条输出 593 token 的完成请求记录 | 同上 |
| 53 tok/s | RTX 5070 + IQ3_S,短聊;官方称是较旧引擎上的对照表 | Strata MODELS.md(官方表;我未复核) |
| 云端 Qwen3.8-Flash | 吞吐依赖区域与负载 | 本文不编造 tok/s;公开价约 Input $0.15 / Output $0.47 per 1M tokens(Qwen Cloud) |
硬件、量化、上下文长度,以及「面板瞬时值 vs 整次请求平均」都不一样。不要把 117 和 125 放在一起比大小——它们只说明各自在原文条件下能到什么量级。
rec README 另称:在 M4 Pro 上相对 llama.cpp 有 1.4–2.6× 吞吐(官方图:4-bit、1K–252K 上下文)。这也是官方数字,我未独立复核。
三、上手:三条可复制路径
A. Flint:Mac 上用 Ollama 或官方 rec
硬件门槛先过一遍:GGUF / rec 都要求 ≥48GB Apple Silicon;rec 还限定 M4 Pro / M5 Pro / M5 Max。选购背景见 Mac 本地推理选购指南。
最快试跑:
ollama run flint
# 可选:直接拉起常见 harness(以 Ollama 页面当时提供的 launch 为准)
# ollama launch claude --model flint
# ollama launch opencode --model flint
官方推荐路径(偏速度):
curl -fsSL https://raw.githubusercontent.com/recursive-oss/rec/main/install.sh | bash
rec launch pi          # 官方称与 pi 搭配效果最好
# rec launch opencode
rec 偏单会话优化;要同时跑多个 agent,需换别的部署方式。接本地 OpenAI 兼容接口时,接口形态差异可对照 三种 LLM 接口。我做的 PiX 也是围绕 pi 的桌面客户端,和 rec launch pi 同属一条生态;下文对 Flint 的判断来自官方文档与硬件门槛,而非本机新测。
B. Strata:在消费级 PC 上跑 Qwen3.8-Flash-Next
Strata 不是第三个模型,而是把 Qwen3.8-Flash-Next(及 Coder / Swift / Gyro 等量化变体)塞进游戏本的那一层:专家缓存、CPU/GPU 协作、可选推测解码。原理和我在 RTX 4090 上看到的面板数字,见 RTX 4090 上看到 117.3 tokens/s。
Terminal 一键装(Linux / Mac):
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh | sh
strata launch
# 脚本 / agent 无交互示例:
# strata launch --model iq2_xs --yes --no-tui
Windows PowerShell:
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex装好后默认监听 http://127.0.0.1:8080:OpenAI 兼容走 /v1,Anthropic 兼容走根路径(客户端自己拼 /v1/messages)。可接 Claude Code、Codex、OpenCode 等。
型号怎么选(摘自官方 MODELS.md,按 RAM+VRAM):
| 内存合计 | 预选倾向 |
|---|---|
| 32 GB | Gyro-S,或写代码用 Coder(约保留一半专家) |
| 40 GB | Swift 1.5 IQ2_XS 等 |
| 48 GB | IQ3_XXS |
| 64 GB | IQ3_S(官方称质量对齐全模型公开测) |
Coder 作者自称保留约 91% 的 SWE-bench Verified、99% LiveCodeBench(经 Strata 文档转述,我未复核)。官方也写明:非代码场景,以及中文等 CJK,可能明显变弱。一般用途优先选保留全部专家的尺寸。
C. 千问 3.8:Qwen3.8-Flash-Next 本地 vs Qwen3.8-Flash 云端
本地开源权重:Qwen/Qwen3.8-Flash-Next。要在单卡消费级机器上舒服用,现实路径就是上一节的 Strata;服务器上可用官方推荐的 SGLang / vLLM / TokenSpeed。
云端托管:模型名 qwen3.8-flash(Qwen Cloud / 阿里云 Model Studio)。官方说明它基于 Qwen3.8-Flash-Next,并带更完整的生产特性(例如默认约 1M 上下文、内置工具)。兼容 OpenAI / Anthropic 协议,方便接 Claude Code、Codex。我在 DeepSeek V4.1 Flash 接进 OMP 和 DSH 做价格对照时,也把 Qwen3.8 Flash 放进「日常编码辅助与较低成本常规任务」一档。
无论本地还是 API,结构化 tool call 都不是安全边界。本地接 Claude Code 时,建议配上 deny 规则,见 Claude Code 权限配置指南。
四、怎么选
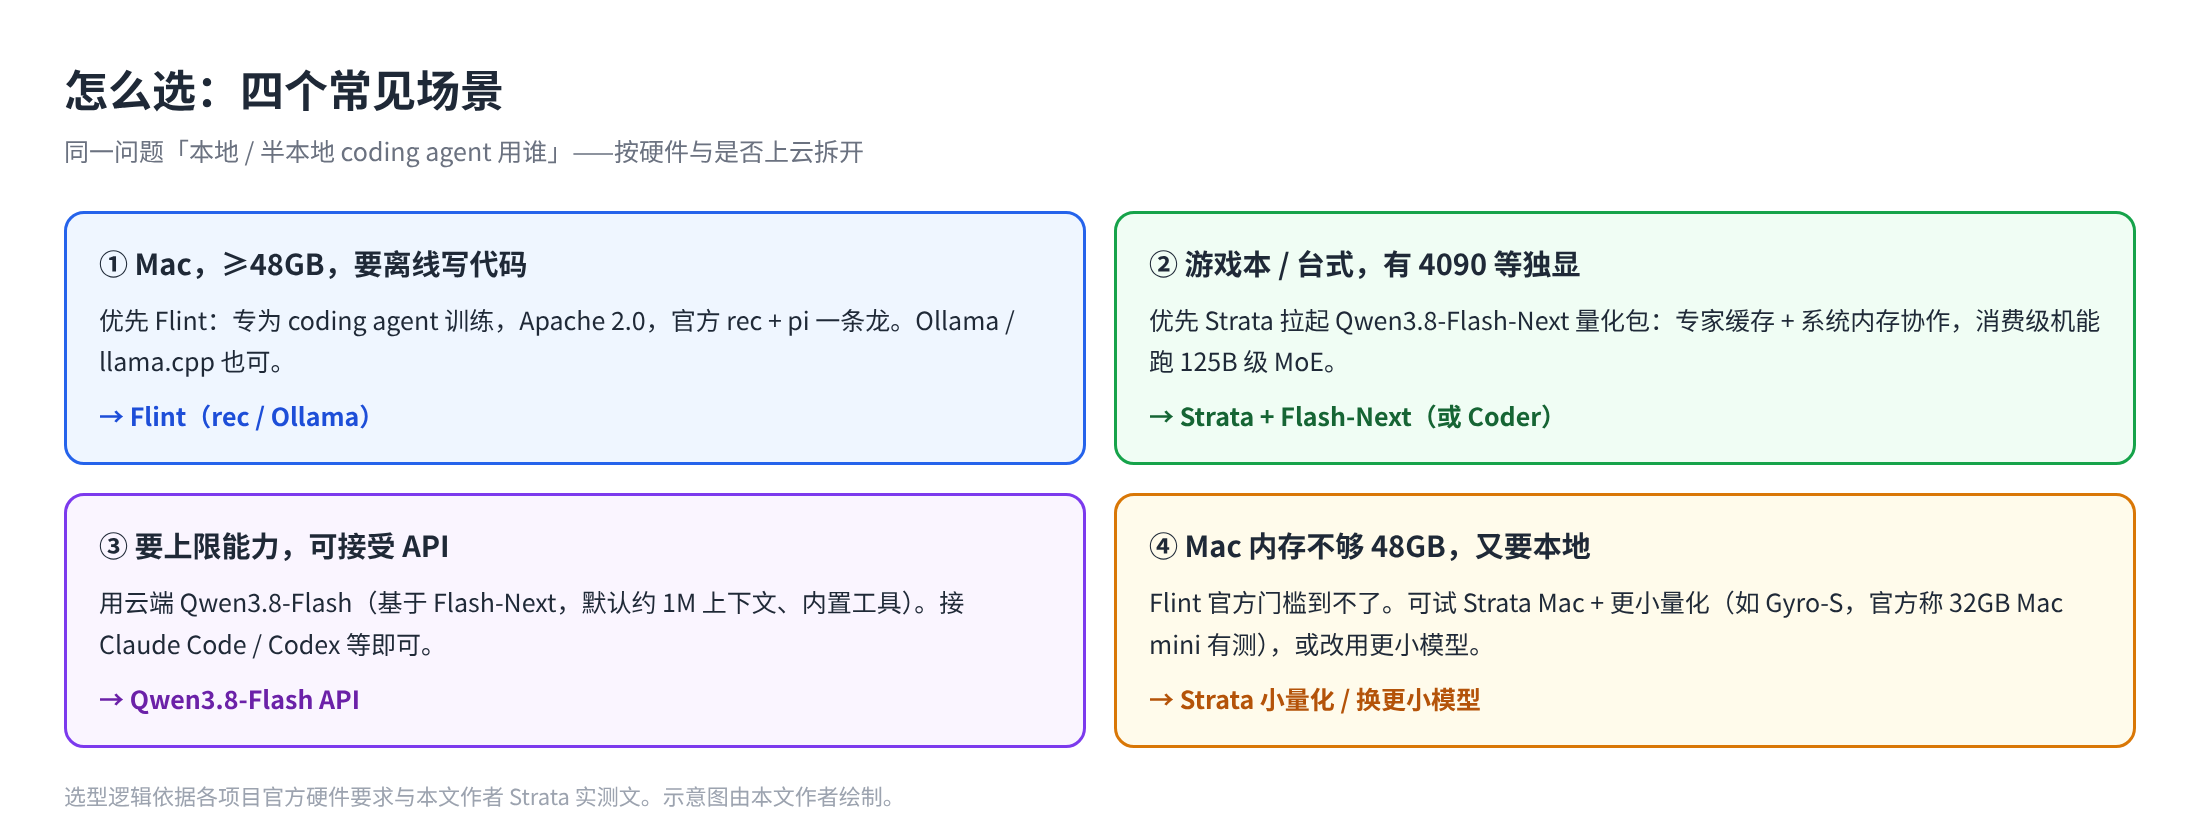
| 你的情况 | 建议 | 理由 |
|---|---|---|
| Mac ≥48GB,要离线 coding agent | Flint(先 ollama run flint,再按需 rec launch pi) |
专为 agent 训练;Apache 2.0;官方 Mac 推理栈完整 |
| 台式 / 游戏本,有 12GB+ 独显 | Strata + Qwen3.8-Flash-Next(内存紧用 Coder) | 把 125B 级 MoE 落到消费级机;OpenAI / Anthropic 双兼容 |
| 要能力上限,可接受数据出本机 | Qwen3.8-Flash API | 免运维;长上下文与内置工具 |
| Mac <48GB,仍想本地 | Strata Mac 小量化(如官方提到的 Gyro-S)或换更小模型 | Flint 官方硬门槛到不了 |
| 只要 27B dense 当日常补全 | Mac 指南 里的 Qwen3.8-27B | 与本文的 Qwen3.8-Flash-Next / Flint 不是同一档问题 |
五、我的看法
我会把这三者看成互补,而不是互替:
- Flint 回答的是:48GB 档 Mac 上,有没有一个为 coding agent 训过、激活又够小的本地模型。约 2.5B 激活、近 40B 总参数,定位清楚;具体手感要以你自己的机器和量化为准。
- Strata 回答的是:没有服务器时,怎么把 Qwen3.8-Flash-Next 这种 125B 级 MoE 塞进 4090。我在 Strata 实测 里强调过:面板上的 117.3 是瞬时 Decode,完成请求记录是 70.0——读监控时不要混。
- 云端 Qwen3.8-Flash 回答的是:不想养推理栈时的上限与稳定性。这和我在 DeepSeek Flash 文里的分工类似——日常用本地或更便宜的模型,重活再上更强的。
如果只能装一个:Mac 大内存选 Flint;NVIDIA / AMD 独显机选 Strata;两边都不想运维就上 Qwen3.8-Flash API。 敏感代码或长时间 agent,权限与沙箱仍要自己管——换模型不会自动换风险模型。
参考资料
- RecursiveSI/flint · Hugging Face
- Introducing Flint · Recursive
- recursive-oss/rec · GitHub
- Niko1221/Strata · GitHub / docs/MODELS.md
- Qwen/Qwen3.8-Flash-Next · Hugging Face
- Qwen3.8-Flash · Qwen Cloud
- 站内:Strata 实测、Mac 本地推理指南、Claude Code 权限指南、DeepSeek V4.1 Flash、PiX、三种 LLM 接口
文中规格依据 2026 年 10 月查阅的官方页面;Flint、Strata、千问都还在快迭代,以当时文档为准。
Comments