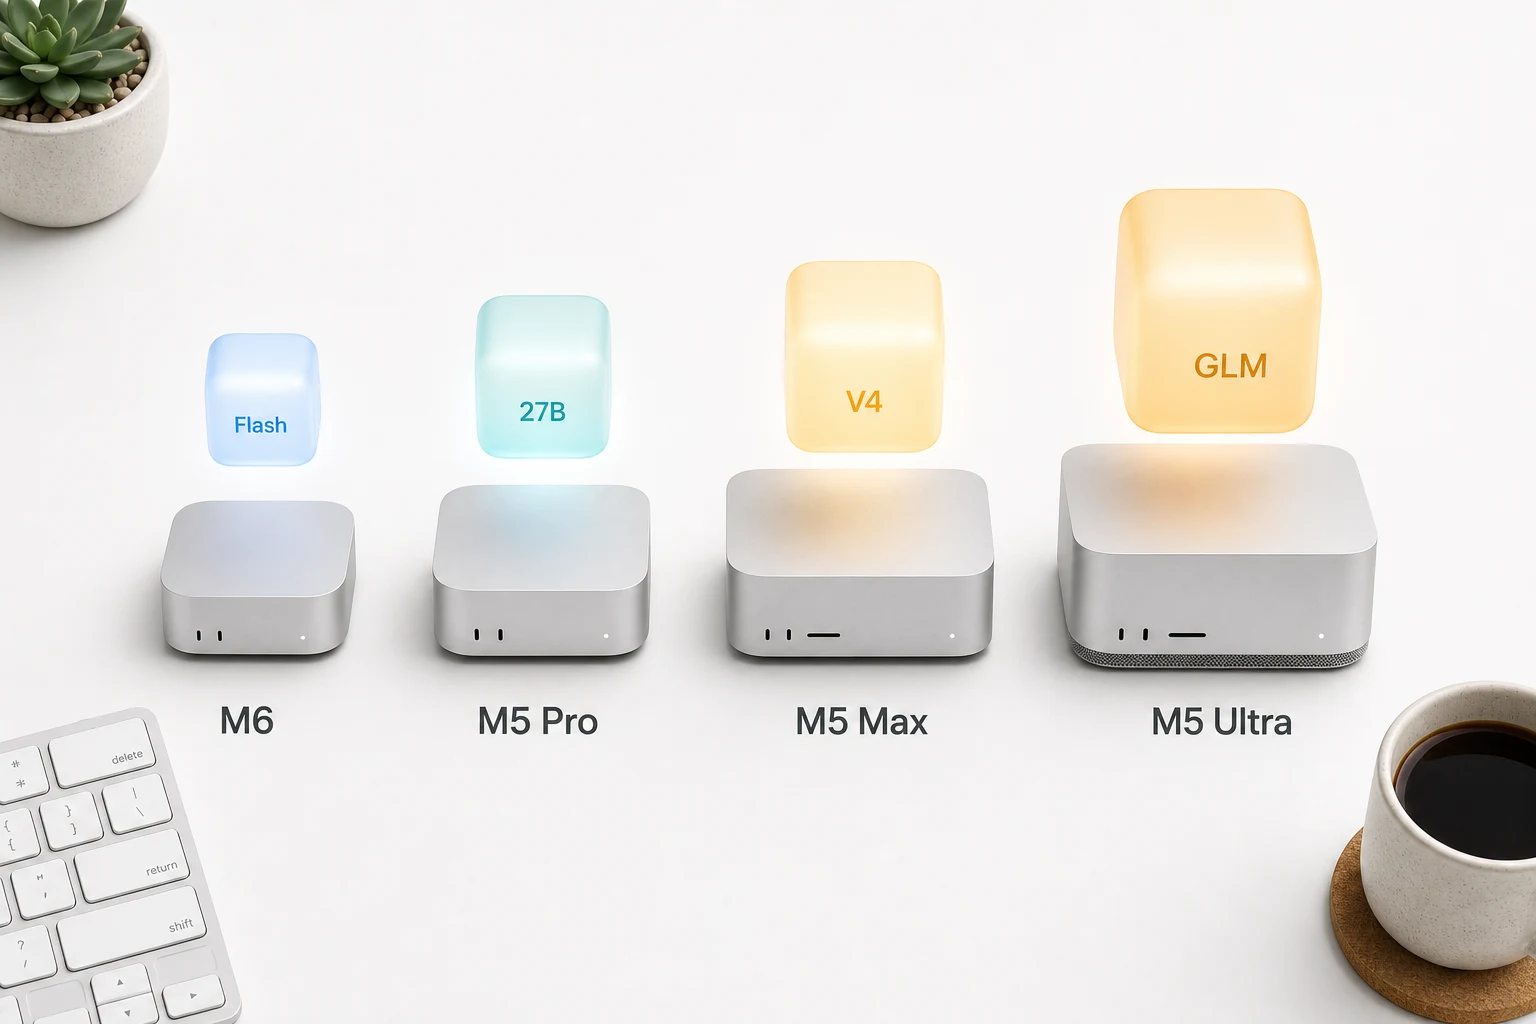
2026 年 8 月 25 日,苹果一口气更新了桌面 Mac 全系:Mac mini 上了首款 2 纳米芯片 M6 和 M5 Pro,Mac Studio 则推出 M5 Max 与全新的 M5 Ultra(最高 512GB 统一内存)。官方把“可在设备端运行超大规模大语言模型”写在 Ultra 的规格上,不是四款机型的共同承诺。
买哪台的问题,其实不是“谁更快”,而是“它能在我桌面上跑多大的模型、跑多快“。这篇文章从本地推理的角度,把四款机型拆开讲清楚。示例用现在还在用的开源主力:Qwen3.8-27B(dense)、DeepSeek-V4-Flash(284B-A13B)、以及 GLM 的两档——轻量的 GLM-4.7-Flash(30B-A3B)和旗舰 GLM-5.2(744B-A40B)。国行 8 月 27 日开始预购,9 月 22 日发售;512GB 内存的 Ultra 要等到 10 月下旬。
决定本地推理能力的两个指标
跑本地 LLM,CPU/GPU 跑分都是次要的,真正决定体验的是两个数字:
- 统一内存(RAM):决定“装得下多大的模型”。模型文件要整个常驻内存,装不下只能靠 SSD 换页(swap),速度会掉到不如小模型。
- 内存带宽(GB/s):决定“生成速度多快”。推理时每个 token 都要把激活的那部分权重过一遍,带宽越高,token/s 越高。同一个 Qwen3.8-27B,在 170GB/s 的机器和 1.2TB/s 的机器上速度能差 4 倍。
所以下面所有讨论都围绕这两个数字展开。有一点必须先说清楚:同一颗芯片的入门档和加配档,带宽并不一样。
一、四款机型一览
| Mac mini M6 | Mac mini M5 Pro | Mac Studio M5 Max | Mac Studio M5 Ultra | |
|---|---|---|---|---|
| 芯片 | M6(2nm,12 核 CPU / 12 核 GPU) | M5 Pro(最高 18 核 CPU / 20 核 GPU) | M5 Max(18 核 CPU / 最高 40 核 GPU) | M5 Ultra(最高 36 核 CPU / 80 核 GPU) |
| 统一内存选项 | 16 / 24 / 32GB | 24 / 48 / 64GB | 36 / 48 / 64 / 128GB | 96 / 256 / 512GB |
| 内存带宽 | 16GB 为 153 GB/s;24–32GB 为 170 GB/s | 307 GB/s | 36GB / 32 核 GPU 为 460 GB/s;48GB 起 / 40 核 GPU 为 614 GB/s | 1.2 TB/s |
| 雷雳端口 | 3×Thunderbolt 4 | 3×Thunderbolt 5(支持多机集群) | Thunderbolt 5(支持集群) | Thunderbolt 5(支持集群) |
| 国行起售价 | 6999 元(16GB 内存 / 256GB 硬盘) | 12999 元(24GB 内存 / 512GB 硬盘) | 19999 元(36GB 内存 / 512GB 硬盘) | 46999 元(96GB 内存 / 1TB 硬盘) |
| 预购 / 发售 | 国行 8/27 预购,9/22 发售 | 同左 | 同左 | 同左(512GB 内存版 10 月下旬) |
两个容易被忽略的点:
- M6 和 M5 系列的每个 GPU 核心都内置了神经网络加速器。这对 Apple 自家模型、图像类任务,以及走 MLX / Core ML 的路径更明显;用 Ollama / llama.cpp 跑开源 GGUF 时,生成速度仍然主要吃内存带宽,神经加速器帮不上太多。
- 带宽的断层比内存更明显,但要看加配:高配之间大致是 170 → 307 → 614 → 1200 GB/s,每一档几乎翻倍。买入门档就不是这个故事——M6 16GB 停在 153 GB/s,M5 Max 36GB 停在 460 GB/s。同款模型在不同机器、甚至同一机型不同配上,体验差异比直觉大得多。
二、模型规模 × 量化 × 内存需求
先建立换算表。开源模型量化到 Q4_K_M(质量和体积的常见平衡点)后,权重文件大约是:总参数量的 0.55 倍 GB,再加上上下文 KV cache 的额外开销。2026 年这批模型原生上下文动辄 200K–1M,KV 比以前狠得多,长上下文时不可忽略,保守按 +15% 算中等窗口。结论如下:
| 档位 | 代表模型(2026 年 8 月) | 量化后约需内存 | 最低建议内存档 |
|---|---|---|---|
| 轻量 MoE | GLM-4.7-Flash(30B-A3B)、Gemma 4 26B(A4B) | ~16–20GB | 24GB |
| 主力 dense | Qwen3.8-27B、Gemma 4 31B | ~18–25GB | 36–48GB |
| 中 MoE | DeepSeek-V4-Flash(284B-A13B) | Q2/Q3 ~100GB;Q4 ~180GB | 128GB(低精度)/ 256GB(Q4) |
| 大 MoE | GLM-5.2(744B-A40B) | 2-bit ~240GB;Q4 ~400GB | 256GB(2-bit)/ 512GB(Q4) |
| 旗舰 MoE | DeepSeek-V4-Pro(1.6T-A49B)、Qwen3.8-2.4T-A95B | 远超 512GB | 不上单机桌面 |
两个补充说明:
- MoE(混合专家)模型看的是激活参数而不是总参数:GLM-4.7-Flash 每次只激活 3B,DeepSeek-V4-Flash 激活 13B,GLM-5.2 激活 40B。所以它们吞吐可以很高,但权重必须整包放内存——这正是 128GB / 256GB / 512GB 内存档存在的意义。
- 上表是“模型常驻 + 中型上下文(8K–32K)“的估算。Qwen3.8-27B 原生 262K、V4-Flash 和 GLM-5.2 原生 1M,真按官方窗口开,内存要再往上挪一档,甚至两档。系统本身还要占将近 10GB,所以”刚刚好塞进权重“通常不够用。
三、带宽决定了生成速度
同样量化下的经验值(第一性原理:token/s ≈ 带宽 / 每 token 读取的激活权重字节数,再打 6–7 折真实效率)。MoE 的生成速度跟激活参数走,跟总参数关系不大;装不装得下才跟总参数走。下表按各机型高配带宽估算:M6 按 170 GB/s(24–32GB),M5 Max 按 614 GB/s(40 核 GPU)。
| 机型(带宽) | GLM-4.7-Flash | Qwen3.8-27B | V4-Flash | GLM-5.2 |
|---|---|---|---|---|
| Mac mini M6(170 GB/s) | ~35–50 tok/s | ~7–9 tok/s | 装不下 | — |
| Mac mini M5 Pro(307 GB/s) | ~55–70 tok/s | ~13–16 tok/s | 装不下 | — |
| Mac Studio M5 Max(614 GB/s) | — | ~25–30 tok/s | Q2/Q3 能跑,偏慢 | 装不下 |
| Mac Studio M5 Ultra(1.2 TB/s) | — | — | Q4 可跑 | 2-bit / Q4 可跑 |
注意:这些是估算区间,真实数字因量化精度、上下文长度、推理引擎而异。入门档会再慢一截——M6 16GB 只有 153 GB/s,M5 Max 36GB 只有 460 GB/s。但结论方向很稳——GLM-4.7-Flash 任何 24GB 以上的机器都流畅;Qwen3.8-27B 想当主力至少要 M5 Pro;V4-Flash 想舒服至少 Ultra 256GB;GLM-5.2 只有 Ultra 扛得住。
四、按机型选模型
Mac mini M6(16–32GB)— 入门推理
- 适合:日常助手、写作/翻译、邮件快速分类、代码补全这类“轻推理”,以及想尝鲜开源的零门槛选择。
- 能装:GLM-4.7-Flash Q4 是这档的甜点(激活只有 3B,24–32GB 流畅);Gemma 4 12B / 26B MoE 也合适。Qwen3.8-27B Q4 在 32GB 上能硬塞进去,大约 7–9 tok/s,只适合偶发,不适合当主力。
- 引擎:Ollama / LM Studio,打开即用。
- 定位:这是“够用”的档位,不是“认真推理”的档位。16GB 带宽只有 153GB/s,就算升到 32GB 也只有 170GB/s,别把 27B dense 当日常。
Mac mini M5 Pro(24–64GB)— 个人工作站
- 适合:个人开发者、本地 coding agent、需要长时间挂着跑的私人推理服务。
- 能装:64GB 版跑 Qwen3.8-27B Q4 非常舒适,还能留出一段长上下文;Gemma 4 31B 同样合适。V4-Flash 和 GLM-5.2 都装不下,建议放弃。
- 亮点:307GB/s 是“base 芯片”和“Pro 芯片”在 AI 体验上的真正分水岭;M5 Pro 版还首次在 mini 上给了 Thunderbolt 5。官方明确说可以用多台 mini 集群,把大模型拆开跑——这是 M6 的 Thunderbolt 4 做不到的。
- 定位:本地推理的甜点档。绝大多数“想本地化、不想太贵”的场景,到这里就停了。2026 年 27B dense 已经能覆盖大部分 coding agent 和办公推理。
Mac Studio M5 Max(36–128GB)— 认真推理
- 适合:需要稳定跑 Qwen3.8-27B 高质量精度,或想在桌面上试 DeepSeek-V4-Flash 的场景,尤其是隐私敏感数据——比如邮件合规审核、金融文档处理这类“不想出本地”的任务。
- 能装:128GB 版 Qwen3.8-27B 可以上 Q6/Q8,长上下文也从容;V4-Flash 只能走 Q2/Q3(大约 100GB 级),能跑但不舒服,Q4(~180GB)装不下。36GB 入门档(32 核 GPU / 460 GB/s)本质上是 27B 的豪华版,买它图的不是 Flash。
- 亮点:加到 40 核 GPU 之后才有 614GB/s 带宽,48 / 64 / 128GB 内存都绑在这档芯片上。想认真跑 27B 或低精度 Flash,不要停在 19999 元的 36GB 起售配置。
- 定位:如果你确定本地推理是长期需求,这是性价比平衡点(性能对得起价格,又不用碰 4.7 万的 Ultra)。单人稳定跑 27B dense,这是四档里最合理的上限;Flash 只是能尝鲜。
Mac Studio M5 Ultra(96–512GB)— 本地化极限
- 适合:跑 DeepSeek-V4-Flash Q4(284B,激活 13B,量化后约 180GB,256GB 才从容);跑 GLM-5.2(744B,激活 40B,2-bit 约 240GB / Q4 约 400GB);做团队共享推理机。
- 能装:96GB 版 ≈ M5 Max 128GB 的容量量级,但带宽翻倍,Qwen3.8-27B 会明显更快;256GB 版是 V4-Flash Q4 的舒适档,GLM-5.2 只能 2-bit;512GB 版才是 GLM-5.2 Q4 的整包解,但要等 10 月下旬。DeepSeek-V4-Pro 和 Qwen3.8-2.4T 单机仍装不下。
- 亮点:1.2TB/s 带宽让稀疏激活的 MoE(Flash 每次只读十几 GB,GLM-5.2 每次约 40B)跑出接近云端的速度;官方宣发 AI 性能最高提升 4.3 倍。Thunderbolt 5 + RDMA 还可以把多台 Studio 组成共享内存池。
- 定位:预算充足的个人 / 小团队,或真的有“超大模型不出门”的硬需求。
五、实用清单
- 先量化,别先换机器:内存吃紧优先上 Q4,甚至 Q3 / 2-bit;追求质量才上 Q8。Ollama 拉取时指定
q4_K_M这类量化即可。V4-Flash 在 128GB 上几乎只能走 Q2/Q3,256GB 再上 Q4。 - 上下文是隐形内存杀手:2026 年模型动辄 200K–1M 窗口,128K 上下文的 KV cache 可能吃掉十几 GB。长上下文需求会直接推高一档内存需求。
- 工具链:Ollama / LM Studio(省心)、MLX(Apple 原生、推理优化好)、llama.cpp 系。vLLM 主要走 CUDA,不适合当作 Mac 本地默认选项。
- 不要依赖 swap:模型超出内存后 Mac 会换页到 SSD,吞吐断崖式下跌,体验远不如降一档量化。
- 买前公式:
模型量化体积 × 1.15 + 系统与其他软件占用 ≈ 所需内存。宁可多一档,不要刚刚好。 - 看芯片别只看机型名:M6 和 M5 Max 的入门带宽都低于宣传里的“最高”数字。为本地推理加内存,往往顺带把带宽也加上了。
六、决策速查
| 你是谁 | 建议配置 |
|---|---|
| 办公 + 博客 + 想试开源 | Mac mini M6 24–32GB,跑 GLM-4.7-Flash(6999 元起,建议不要停在 16GB) |
| 开发者,想本地跑 Qwen3.8-27B | Mac mini M5 Pro 48–64GB(约 1.4–1.6 万) |
| 隐私敏感任务,想稳定跑 27B / 试 V4-Flash | Mac Studio M5 Max 128GB(40 核 GPU,约 3 万出头) |
| V4-Flash Q4 / GLM-5.2 / 团队共享 | Mac Studio M5 Ultra 256–512GB(4.7 万起) |
结论
一句话版:M6 是“够用”,M5 Pro 是“甜点”,M5 Max 是“认真”,M5 Ultra 是“极限”。
如果你做的是邮件合规这类“规则 + LLM + 人工”的混合流程——优势在于模型其实不用很大:混合方案里 LLM 只需承担分类、提取、初判,复核交给规则和人工,GLM-4.7-Flash 或 Qwen3.8-27B 通常就够,V4-Flash 是保险。这种情况下 M5 Max 128GB 是四档里最值得考虑的:预算压力远小于 Ultra,能力上覆盖了 27B dense 和低精度 Flash,还能把敏感数据稳稳留在本地。不要被 19999 元的 36GB 起售价吸引——那档带宽和内存都跑不好 Flash。
真正需要犹豫是否上 Ultra 的,只有两类人:要 Q4 整包跑 DeepSeek-V4-Flash 或 GLM-5.2 的,以及把桌面推理机当小团队公共服务用的。
Comments