14 天系列的补篇,不是 Day N。相关阅读:什么是 Agent Harness · Day 03:LLM Chat Loop
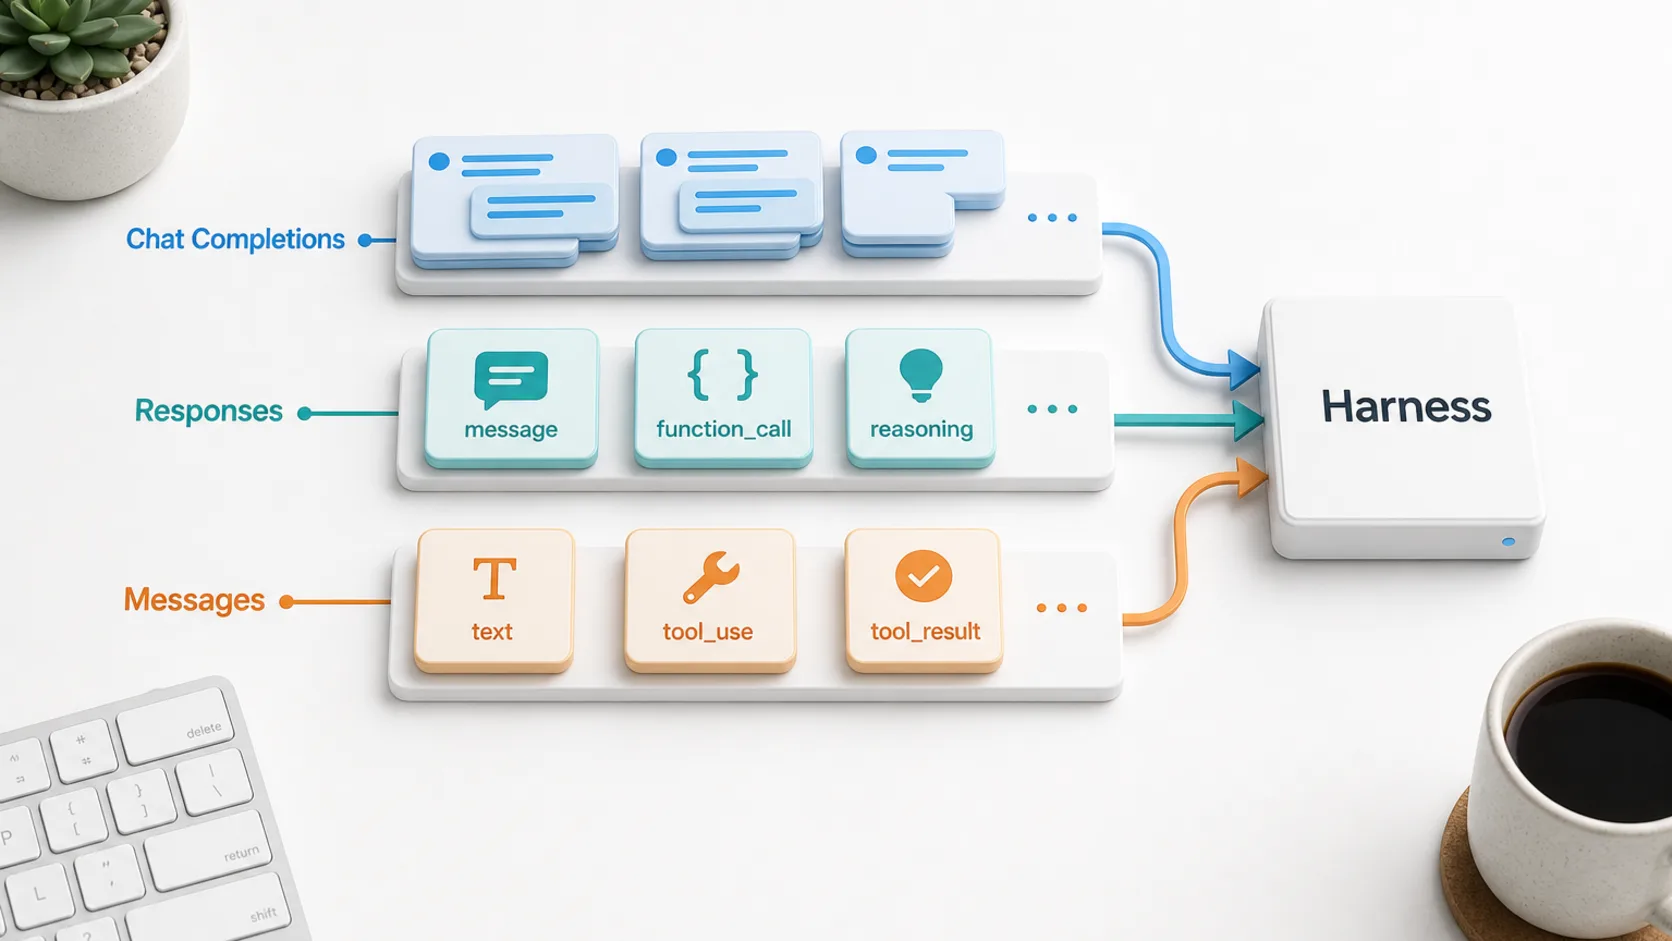
写集成模型的时候,最常见的困惑不是“调哪个模型”,而是“同一件事,为什么三种 SDK 写法完全不一样”。
同样是“让模型读一个文件然后总结”,OpenAI 叫你拼 messages 数组,过几天又出了个 input + items 的用法;Anthropic 让你往 content 里塞 block。如果不弄清这三个接口背后的设计逻辑,写出来的 harness 要么深度绑定某一家,要么在翻译层里反复打补丁。
这篇文章把三个接口按同一个骨架拆开对比:
- Chat Completions(OpenAI,
/v1/chat/completions) - Responses(OpenAI,
/v1/responses) - Messages(Anthropic,
/v1/messages)
对比的维度是六个:请求结构、工具调用循环、流式协议、结构化输出、状态管理、计费与缓存。最后给出选型建议。
一、为什么会有三种接口
三个接口不是同一代产品,理解这一点比背字段更重要。
Chat Completions 诞生于 2023 年 GPT-3.5 时代。它把“对话”抽象成一条 messages 数组,每条消息带一个 role。设计上它做对了一件事——把“系统提示词、用户输入、历史、工具结果”全部压进同一个数组,用一个 role 字段区分。这让它成为事实上的兼容标准:DeepSeek、vLLM、Ollama、几乎所有本地推理服务都实现了 /chat/completions。
但它的缺点同样来自这个设计:一切状态都在客户端。每一次请求都要把全部历史重发一遍,工具调用要自己维护 tool 消息对,流式输出只有 token 增量的概念,没有“结构化单元”的概念。
Anthropic Messages 诞生于 2023 年底(Claude 2.1 时代),是 Anthropic 对大模型接口的另一种回答。它的核心抽象是 content block:一段对话里每个 turn 的 content 不再是一段字符串,而是一组有类型的块——文本、图片、PDF、tool_use、tool_result、thinking。系统提示词也独立成顶层字段,而不是塞进消息数组。
OpenAI Responses 诞生于 2025 年 3 月。它是 OpenAI 对“agent 需要什么”的直接回应:把之前散落在 Chat Completions(对话)、Assistants(工具 + 状态)、Batch/Multimodal 的能力收敛成一个统一 primitives。它的核心抽象是 item:message、function_call、function_call_output、reasoning 都是同级的 item,永续存在 output / input 数组里;还引入了 previous_response_id 服务端状态。
一句话概括三者的关系:
| 接口 | 核心抽象 | 状态归谁 | 诞生背景 |
|---|---|---|---|
| Chat Completions | message(带 role 的字符串) | 客户端全量维护 | GPT-3.5,把 chat 做成标准 |
| Messages | content block(有类型的块) | 客户端全量维护 | Claude,把多模态/工具做成块 |
| Responses | item(message / function_call / reasoning) | 服务端可选托管 | GPT-5 时代,为 agent 重构 |
二、先看一张总览表
下面这张表是三者的“三分钟速览”,后文逐项展开:
| 维度 | Chat Completions | Responses | Anthropic Messages |
|---|---|---|---|
| 端点 | POST /v1/chat/completions |
POST /v1/responses |
POST /v1/messages |
| 系统提示词 | messages 里的 system role |
顶层 instructions 字段 |
顶层 system 字段 |
| 对话输入 | messages[] |
input(字符串或 item 数组) |
messages[] |
| 角色/类型 | role: system/user/assistant/tool |
item type: message/function_call/function_call_output/reasoning |
role: user/assistant + block type |
| 工具定义 | 嵌套 function 字段 |
扁平 name/parameters |
扁平 input_schema |
| 工具回传 | role:"tool" + tool_call_id |
function_call_output item + call_id |
user 消息里的 tool_result block |
| 最大输出 | max_completion_tokens |
max_output_tokens |
max_tokens(必填) |
| 流式协议 | SSE,delta 增量 |
SSE,item 级事件 | SSE,content_block 级事件 |
| 结构化输出 | response_format.json_schema |
text.format |
output_config.format(2026 官方支持) |
| 内置工具 | 无(只有自定义 function) | 有(web_search / file_search / code_interpreter 等) | 有(web_search / computer use 等) |
| 服务端状态 | 无 | previous_response_id + store |
无(有 prompt caching) |
| 显式缓存控制 | 无(自动缓存) | 无(自动缓存) | cache_control 断点 |
三、请求结构:对话从哪里开始
3.1 系统提示词
同样是“你是编码助手”,三家的写法分别是:
// Chat Completions:system 是 messages 里的一条
const res = await client.chat.completions.create({
  model: "gpt-5.5",
  messages: [
    { role: "system", content: "You are a concise coding assistant." },
    { role: "user", content: "Summarize the repository." },
  ],
});
// Responses:instructions 是顶层字段
const res = await client.responses.create({
model: "gpt-5.5",
instructions: "You are a concise coding assistant.",
input: "Summarize the repository.",
});// Anthropic Messages:system 是顶层字段,messages 里没有 system role
const res = await client.messages.create({
model: "claude-opus-4-8",
max_tokens: 2048,
system: "You are a concise coding assistant.",
messages: [{ role: "user", content: "Summarize the repository." }],
});这里有一个值得注意的差异:Anthropic 不接受 system 出现在 messages 里,OpenAI 的 Chat Completions 则把 system 当成 messages 的一部分、按位置生效。Responses 更进一步——instructions 是顶层字符串(不是数组),语义上更像“跨回合的恒定指令”,配合 previous_response_id 每次重传即可在保有历史时替换它。
对 harness 的启示:system prompt、项目规则、工具描述在 Anthropic 里有一个天然的分层位置(system 字段可以做 cache_control 缓存断点),在 OpenAI 里则要自己拼字符串。上下文构建器(Context Builder)输出的结构,最后映射到哪个接口的哪个字段,是不同的。
3.2 对话历史
Chat Completions 和 Anthropic Messages 都是无状态的:客户端要自己保存全部历史,每次请求整体重发。区别在于 Anthropic 要求遵守交替规则——user/assistant 消息必须严格交替,连续两条相同 role 会报错;而 OpenAI 对相邻消息比较宽容(虽然官方也建议合并)。
Responses 是三者里唯一有服务端状态的。三种用法按复杂度递进:
input传字符串:最简单的一次性问答。input传 item 数组:把上一轮response.output原样接回来,附上新的 function_call_output / 用户消息。previous_response_id:只传新增内容,历史由服务端托管(配合store: true或自动保存)。此时instructions可以继续覆盖,input里缺的上下文模型也能看到。
第三种的代价是:开了服务端状态,解析后的输入/输出 token 会分别计一次费(后面讲 usage 时再说),而且状态在服务端的保留时长有限。对追求可复现、可审计的 harness 来说,“把整个会话明文放进每次请求”反而更透明。
3.3 多模态输入
同一张图片,三种数据结构:
// Chat Completions:content 是数组,图片是 image_url
{ role: "user", content: [
  { type: "text", text: "What is in this image?" },
  { type: "image_url", image_url: { url: "data:image/png;base64,..." } },
] }
// Responses:input 图片部分叫 input_image
{ type: "message", role: "user", content: [
{ type: "input_text", text: "What is in this image?" },
{ type: "input_image", image_url: "data:image/png;base64,..." },
] }// Anthropic:image block,base64 必须显式声明 media_type
{ role: "user", content: [
{ type: "text", text: "What is in this image?" },
{ type: "image", source: { type: "base64", media_type: "image/png", data: "..." } },
] }Anthropic 还有另外两家没有的文件类型:document block(原生 PDF 解析)。另外注意细节:Responses 的输入部分叫 input_text/input_image,输出部分叫 output_text/output_image,命名本身就是“对话方向”的提示。
四、工具调用:三种循环
工具调用是三个接口差异最大、也是 harness 最关心的地方。我们用同一个 read_file 工具走完三种“定义 → 调用 → 回传”的循环。
4.1 工具定义
// Chat Completions:type 里嵌套 function 字段(历史包袱)
const tools = [{
  type: "function",
  function: {
    name: "read_file",
    description: "Read a UTF-8 text file from the workspace.",
    parameters: {
      type: "object",
      properties: {
        path: { type: "string", description: "Workspace-relative path." },
      },
      required: ["path"],
      additionalProperties: false,
    },
  },
}];
// Responses:扁平结构,name 直接在顶层
const tools = [{
type: "function",
name: "read_file",
description: "Read a UTF-8 text file from the workspace.",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "Workspace-relative path." },
},
required: ["path"],
additionalProperties: false,
},
}];// Anthropic:input_schema 代替 parameters
const tools = [{
name: "read_file",
description: "Read a UTF-8 text file from the workspace.",
input_schema: {
type: "object",
properties: {
path: { type: "string", description: "Workspace-relative path." },
},
required: ["path"],
},
}];第一眼看是“同一件事的三种写法”,但背后有两个结构性的区别:
- Chat Completions 的
function嵌套是历史痕迹——早期为了兼容 deprecated 的functions参数而保留的。JSON Schema 的additionalProperties:false只在 OpenAI 侧有意义(配合 strict 模式),Anthropic 的 schema 校验更宽松。 - 内置工具:Responses 和 Messages 都带内置工具(网页搜索、代码解释器等),其中 Responses 的自定义工具类型也叫
function,但内置的web_search、file_search、code_interpreter直接{type:"web_search"}就能开,不用写 schema。Chat Completions 没有内置工具,全部要自己实现。
4.2 模型说“我要读文件”
模型决定调工具时,三个接口通知你的位置完全不同:
// Chat Completions:在 message.tool_calls 里
const message = res.choices[0].message;
message.tool_calls; // [{ id: "call_abc", type: "function",
                    //    function: { name: "read_file", arguments: '{"path":"README.md"}' } }]
message.content;    // null —— 文本和工具调用互斥
// Responses:output 里是一个 function_call item
res.output.find((item) => item.type === "function_call");
// { id: "fc_123", call_id: "call_xyz", type: "function_call",
// name: "read_file", arguments: '{"path":"README.md"}' }
res.output_text; // 顶层便捷属性,本轮所有文本拼接// Anthropic:content 里是一个 tool_use block
res.content.find((block) => block.type === "tool_use");
// { type: "tool_use", id: "toolu_123", name: "read_file", input: { path: "README.md" } }
res.stop_reason; // "tool_use" —— 模型主动停住等结果三个细节值得记住:
- Anthropic 的
input已经是对象({"path":"README.md"}),OpenAI 两侧都要自己JSON.parse(arguments)。 - Chat Completions 里
content会是null——一旦走工具调用,这一轮的文本就没了。所有“直接读content拼 UI”的代码都会在这里踩空。 - 响应里的标识符名称不同:Response item 同时有
id和call_id,回传时引用的是call_id;Anthropic 用tool_useblock 的id;Chat Completions 用tool_calls[i].id。
4.3 结果回传
执行完 read_file,把结果还给模型:
// Chat Completions:push 一条 role:"tool" 的消息
messages.push(message);                                   // 原样存 assistant
messages.push({ role: "tool", tool_call_id: call.id, content: fileText });

// Responses:把上一轮 output 接回 input,再追加 function_call_output item
await client.responses.create({
  model,
  instructions: "...",
  input: [
    ...res.output,
    { type: "function_call_output", call_id: call.call_id, output: fileText },
  ],
});

// Anthropic:新增一条 user 消息,里面放 tool_result block
await client.messages.create({
  model,
  max_tokens: 2048,
  system: "...",
  messages: [
    { role: "user", content: "Summarize the repository." },
    { role: "assistant", content: res.content },          // tool_use 原样回传
    { role: "user", content: [{ type: "tool_result", tool_use_id: use.id, content: fileText }] },
  ],
});三种做法的本质是同一个协议:assistant 说要调工具 → 系统执行 → 把结果以“工具产出”的身份放回对话。差异在于回传的载体:
| Chat Completions | Responses | Anthropic | |
|---|---|---|---|
| 回传载体 | 消息 role | item type | content block |
| 引用字段 | tool_call_id |
call_id |
tool_use_id |
| 历史里占几条 | 2 条(assistant + tool) | 2 个 item(function_call + output) | 2 条(assistant + user) |
| 工具结果失败 | content 里写错误文本 | output 字段写错误文本 |
is_error: true 显式标记 |
Anthropic 多做了一层正确性检查:tool_use block 所在的 assistant 消息必须原样回传。assistant 可以同时带文本和 tool_use,但文本必须在 tool_use 前面;紧接着的 user 消息必须带对应的 tool_result,且 tool_use / tool_result 不能交错。这保证了你不能偷偷改掉模型的调用。
4.4 完整的两轮循环
把上面的片段拼成完整可运行的工具循环(第一轮:读文件;第二轮:模型输出总结):
// ---------- Chat Completions ----------
const messages = [
  { role: "system", content: "You are a coding assistant." },
  { role: "user", content: "Read README.md and summarize it." },
];

let res = await client.chat.completions.create({ model, messages, tools });
const first = res.choices[0].message;

if (first.tool_calls?.length) {
  const call = first.tool_calls[0];
  const fileText = await readFile(JSON.parse(call.function.arguments).path);
  messages.push(first);
  messages.push({ role: "tool", tool_call_id: call.id, content: fileText });
  res = await client.chat.completions.create({ model, messages, tools });
}
console.log(res.choices[0].message.content);
// ---------- Responses ----------
let res = await client.responses.create({
model, instructions: "You are a coding assistant.",
input: "Read README.md and summarize it.", tools,
});
const call = res.output.find((i) => i.type === "function_call");
if (call) {
const fileText = await readFile(JSON.parse(call.arguments).path);
res = await client.responses.create({
model, instructions: "You are a coding assistant.",
input: [
...res.output,
{ type: "function_call_output", call_id: call.call_id, output: fileText },
],
tools,
});
}
console.log(res.output_text);// ---------- Anthropic Messages ----------
const conversation = [{ role: "user", content: "Read README.md and summarize it." }];
let res = await client.messages.create({ model, max_tokens: 2048, system: "You are a coding assistant.", messages: conversation, tools });
const use = res.content.find((b) => b.type === "tool_use");
if (use) {
const fileText = await readFile(use.input.path);
conversation.push({ role: "assistant", content: res.content });
conversation.push({ role: "user", content: [{ type: "tool_result", tool_use_id: use.id, content: fileText }] });
res = await client.messages.create({ model, max_tokens: 2048, system: "You are a coding assistant.", messages: conversation, tools });
}
console.log(res.content.map((b) => (b.type === "text" ? b.text : "")).join(""));可以看到:三者做同一件事的代码量几乎一样。真正的差异不在“能不能做”,而在“建模方式”——messages / items / content blocks 三种心智模型。如果你的 harness 只绑定其中一种,切换供应商就是要重写 agent loop。
4.5 tool_choice:谁能决定用哪个工具
tool_choice 三个接口都有,但语义不完全对齐:
// Chat Completions
tool_choice: "auto" | "none" | "required" | { type: "function", function: { name: "read_file" } }

// Responses
tool_choice: "auto" | "none" | "required" | { type: "function", name: "read_file" }

// Anthropic
tool_choice: { type: "auto" } | { type: "any" } | { type: "tool", name: "read_file" }
注意 Anthropic 的 any(必调工具但模型自选)对应 OpenAI 的 required(同样语义)——同一个概念,OpenAI 用字符串,Anthropic 用对象。写兼容层时这是最常见的边界条件之一。
五、流式协议:三种 SSE
流式输出是区分“接口设计是否 agent-ready”的最明显标尺。三者都是 SSE,但粒度完全不同。
Chat Completions:token 增量。 每个 chunk 是 choices[0].delta 的一块:
data: {"choices":[{"delta":{"role":"assistant","content":"Re"}}]}
data: {"choices":[{"delta":{"content":"ading README"}}]}
data: {"choices":[{"delta":{"content":"..."}}]}
data: {"choices":[{"delta":{},"finish_reason":"stop"}]}
data: [DONE]
工具调用时增量会变成 delta.tool_calls 的 fragment(带 index),你要在客户端自己按 index 聚合 arguments 字符串。没有“这条消息完了”的边界事件。
Anthropic Messages:content block 生命周期。 事件围绕 block 的开、续、停展开:
event: message_start
event: content_block_start   {"content_block":{"type":"text","text":""}}
event: content_block_delta   {"delta":{"type":"text_delta","text":"Reading"}}
event: content_block_delta   {"delta":{"type":"text_delta","text":" README"}}
event: content_block_stop
event: message_delta         {"delta":{"stop_reason":"end_turn"},"usage":{...}}
event: message_stop
工具参数走 input_json_delta,thinking 走 thinking_delta。每一个 block 都有明确的开始和结束,天然形成“内容单元”。
Responses:item 级事件。 事件名直接描述“发生了什么”:
event: response.created
event: response.output_item.added       {"output_index":0,"item":{"type":"message",...}}
event: response.content_part.added
event: response.output_text.delta       {"delta":"Re"}
event: response.output_text.delta       {"delta":"ading"}
event: response.output_text.done
event: response.content_part.done
event: response.output_item.done
event: response.completed                {"response":{...完整对象...}}
对 agent harness 来说,Responses 的流式协议有非常实际的好处:事件本身就可以直接变成 transcript。output_item.added / done 的边界对应一次工具调用的生命周期,function_call_arguments.delta 对应参数流式到达。Claude Code / Codex 这类产品的“步骤可视化”,在 Responses 上几乎是零成本还原的;Chat Completions 的 token 增量则需要额外维护状态机才能拼出“哪一次调用、哪个参数、什么时候完成”。
Anthropic 的 block 生命周期和 Responses 的 item 生命周期,本质是同一个思想(有边界的结构化单元),只有命名习惯不同:Anthropic 更“消息为中心”,OpenAI 更“行为为中心”。
六、结构化输出
让模型“必须返回符合 schema 的 JSON”,三家现在的做法都收敛到了 constrained decoding(约束解码),但字段名完全不同:
// Chat Completions:response_format 嵌套 json_schema
await client.chat.completions.create({
  model, messages,
  response_format: {
    type: "json_schema",
    json_schema: { name: "summary", strict: true, schema: { /* JSON Schema */ } },
  },
});
// Responses:放在 text.format,因为"文本输出"本身是一个可配置的 item
await client.responses.create({
model, instructions, input,
text: { format: { type: "json_schema", name: "summary", strict: true, schema: { /* JSON Schema */ } } },
});// Anthropic Messages:2026 年官方支持的 output_config(SDK 里也叫 output_format)
const res = await client.messages.create({
model: "claude-sonnet-4-6", max_tokens: 1024, messages,
output_config: {
format: { type: "json_schema", schema: { /* JSON Schema */ } },
},
});
// SDK 把解析好的结果暴露在 res.parsed_output注意 Anthropic 在写法上确实和 OpenAI 有别:OpenAI 两个端点在响应体里给你原始 JSON 字符串(自己 parse),而 Anthropic 的 SDK 直接把解析结果暴露在 parsed_output 字段。另外 Anthropic 还有一条历史路径——先用 tool use 强制 schema:把“输出”定义成一个没有实际用途的 output 工具,模型必须调用它、参数就是你的结构。这条路在 2026 年之前是 Anthropic 唯一官方保证 schema 合规的方式,现在被 output_config 取代了,但大量现存代码还在用。
三家共同的限制也值得写进 harness 的文档:strict / constrained 模式下 JSON Schema 有格式约束(不支持部分 anyOf/oneOf、default 等),字段名会被约束为合法标识符风格,additionalProperties:false 必须显式声明。不同厂商对“schema 不合法”的反应不同:OpenAI 直接 400,Anthropic 会在日志里警告。
七、状态管理与多轮对话
这是 Responses 和另外两家拉开差距的地方。
Chat Completions / Anthropic Messages:无状态,每轮全量重发。Anthropic 通过 prompt caching(cache_control)把这个昂贵的行为变便宜——system、工具定义、历史可以打上缓存断点,命中后按 cache_read_input_tokens 计数而不是全价 input_tokens。OpenAI 也自动做 prompt caching(到一定 token 量起,记在 prompt_tokens_details.cached_tokens),只是不可控。
Responses:previous_response_id 让“上下文”从客户端搬到了服务端:
// 第一轮不写 previous_response_id
const r1 = await client.responses.create({ model, instructions, input: "Tell me about this repo." });

// 第二轮只传新增内容 + 引用上一轮
const r2 = await client.responses.create({
  model,
  previous_response_id: r1.id,
  input: "What about the build scripts?",
});
代价与边界:
- 计费:开启状态托管后,对话的输入 token 会“解析一次、再编码一次”,单轮成本变高;服务端历史也有保留时长上限。
- 可复现性:服务端状态是隐式的,transcript / 审计要另想办法;而全量明文发送的请求天然可复现、可重放。
- 跨模型:状态是 OpenAI 服务端的概念,切到 Anthropic 或本地模型时
previous_response_id不存在,你的 harness 必须回到“全量重发”路径。
对 harness 的结论很直接:写兼容层时,把“全量重发”当作基准路径,把 previous_response_id 当作优化项,而不是反过来。
八、思考与推理
推理型模型的输出,三个接口也都给了显式位置:
| 请求参数 | 响应里的形态 | |
|---|---|---|
| Chat Completions | reasoning_effort: "low"/"medium"/"high" |
思考过程不进 content,只在 usage.completion_tokens_details.reasoning_tokens 计数 |
| Responses | reasoning: { effort, summary: "auto"/"concise"/"detailed" } |
output 里的 reasoning item,默认只有摘要,全文要 include 指定 |
| Anthropic Messages | Opus 4.8+:thinking: { type: "adaptive" };更早模型:type: "enabled" + budget_tokens |
content 里的 thinking block(含 signature,续对话必须回传) |
几个关键差异:
- Anthropic 的 thinking 内容默认就在 content 里(可以关),OpenAI 的推理内容默认不进对话、只给摘要或 reasoning tokens 计数。
- Anthropic 开 thinking 有限制:temperature / top_p / top_k 必须保持默认。Opus 4.8 只接受
type: "adaptive",旧的enabled+budget_tokens会 400。stop_reason: "pause_turn"是 web search 这类 server tool 暂停回合,不是 thinking 预算耗尽。 - Responses 的 reasoning 摘要默认不回显,要在
include里点名才返回——这是为了省 token,但因为太隐蔽,很多人第一次接 Responses 会以为推理被隐藏了。 - Responses 做 function calling 时,上一轮
output里的reasoningitem 必须原样回传。滤掉之后常见报错是function_call was provided without its required reasoning item。
九、usage 与缓存
三个 usage 对象长得像,字段含义不同,混着读会算错账:
// Chat Completions
usage: {
  prompt_tokens: 1200, completion_tokens: 150, total_tokens: 1350,
  prompt_tokens_details: { cached_tokens: 1000 },          // 自动缓存
  completion_tokens_details: { reasoning_tokens: 80 },     // 推理 token
}

// Responses —— 注意名字变成 input/output
usage: {
  input_tokens: 1200, output_tokens: 150, total_tokens: 1350,
  input_tokens_details: { cached_tokens: 1000 },
  output_tokens_details: { reasoning_tokens: 80 },
}
// 开 previous_response_id 状态托管时,还会有 parse 阶段的额外计费项

// Anthropic —— 缓存是显式的
usage: {
  input_tokens: 1200, output_tokens: 150,
  cache_creation_input_tokens: 0,   // 写缓存
  cache_read_input_tokens: 1000,    // 读缓存
}结论:OpenAI 的缓存是黑盒自动的,Anthropic 的缓存是白盒可控的。前者省心但不可预测,后者要在“打多少断点 / 放哪个断点”上做工程权衡——断点打错位置,缓存命中率上不去,费用反而更高。
十、各自的坑
按踩坑频率排序,每个接口最容易出问题的点:
Chat Completions
message.content在工具调用时为null,任何无判断的content!都会炸。- 工具定义里那个多余的
function嵌套,写错一层(把function漏掉)是最常见的报错来源之一。 - 流式工具调用要自己按
index聚合参数 JSON,聚合错误很难定位。 max_tokens和max_completion_tokens并存过渡期,混用容易产生奇怪报错。
Responses
input的 item 类型多(message / function_call / function_call_output / reasoning / web_search_call…)。手动续轮时应把上一轮output(含reasoning)原样接回去,再追加function_call_output;滤掉 reasoning 反而会 400。- 用过
previous_response_id后忘记处理指令覆盖,或反之,状态行为不符合预期。 - 服务端状态让计费多一档,费用模型和 Chat Completions 不一样,预算对比要换算。
- 事件流里
response.output_text.done和response.output_item.done的时序关系需要仔细对待(文本完成 ≠ item 完成)。
Anthropic Messages
max_tokens必填,漏了直接 400——这是从 OpenAI 系迁过来第一脚就会踩的。messages里的 role 严格交替,user/user 或 assistant/assistant 连续会报错,多轮拼接时必须 merge 相邻消息。tool_use所在的 assistant 消息必须原样回传,不能改写内容(会校验)。- 图片必须 base64 + 显式
media_type,“图片太大/格式不对”的错误不像 OpenAI 会帮你兜。 - thinking 与 temperature 互斥,开了 thinking 又调温度会报错。
十一、选型建议
站在 2026 年的时点,直接给结论:
选 Chat Completions 当兼容基线,不代表永远只调 Chat Completions。
现实是:本地模型、DeepSeek、vLLM、Ollama、中间层服务几乎全部实现了 /chat/completions,它是事实上的“最低公分母”。你的 harness 如果不打算深度绑定某一家,ModelProvider 接口的第一实现应该基于它——这也是这个系列里 Day 03 的默认 provider 走 OpenAI-compatible 端点的原因。
面向 agent 功能选 Responses。 如果产品的主战场是 OpenAI 模型,且你需要内置工具(web search / file search / code interpreter)、服务端状态、或“流式事件即 transcript”,Responses 是唯一把这些做成第一公民的接口。OpenAI 官方也已明确:新能力只会优先落到 Responses,Assistants API 正在被官方引导迁移,新项目不该再以它为起点。
选 Anthropic Messages 当“高质量多模态 + 可控成本”的选项。 长上下文、PDF 原生解析、显式缓存断点、thinking 全程可见,这些对 coding agent 很值钱;代价是接口形态离 OpenAI 系最远,写适配层时注意 tool_use 回传和消息交替规则。
一张需求表收尾:
| 你的需求 | 推荐 |
|---|---|
| 兼容最多模型 / 本地部署 / 中间层服务 | Chat Completions(OpenAI-compatible 端点) |
| 只用 OpenAI 生态,要多轮状态、内置工具 | Responses |
| Claude 生态、长上下文 + 可控缓存成本 | Anthropic Messages |
| 多供应商可插拔的 harness | 内部统一抽象(message + tool_call + tool_result),每个接口只写一个 adapter |
| 流式事件要做成可审计的 transcript | Responses 或 Anthropic(都是单元级事件) |
小结
三个接口的差异,归根到底是三句话:
- Chat Completions 把一切做成“带 role 的消息”——简单、兼容、状态在你手里。
- Anthropic Messages 把一切做成“有类型的 content block”——结构化、严格、多模态和工具是第一公民。
- Responses 把一切做成“item”并把状态交给服务端——为 agent 而生的统一 primitives。
它们不是三个版本的同一 API,而是三种不同的心智模型。能同时用这三种接口的思维写 harness,才不会在供应商之间反复重写 agent loop。
如果你在写自己的 provider 抽象层,建议下一步读系列里的 Day 03:LLM Chat Loop,看一个不绑定任何供应商的 ModelProvider 接口长什么样。
Comments